Distributed RAID für ZFS

Großer Storage ohne Scale-out-Komplexität

dRAID verteilt Daten, Parität und optionale Reservekapazität über eine größere Laufwerksanzahl. Es ist eine kostenbewusste Option, wenn ein großes Storage-System benötigt wird – nicht unabhängiges Scale-out über mehrere Knoten.

Unterstützte euroNAS-Produkte: euroNAS Premium und euroNAS HA Cluster.

Große Laufwerksanzahl12 bis 255 ausgewählte Datenlaufwerke im aktuellen euroNAS-Erstellungsablauf
dRAID-vdevKonfigurierbare einfache, doppelte oder dreifache Parität
Verteilte Recovery-KapazitätÜber beteiligte Laufwerke reserviert, nicht auf einem ungenutzten Spare konzentriert
Datei- und BlockdiensteKapazität wird über die benötigten euroNAS-Storage-Dienste bereitgestellt
Die zentrale Idee

Recovery-Arbeit und reservierter Spare-Bereich werden verteilt

Aktiviert die Recovery-Logik einen Distributed Spare, stellen die verbleibenden Laufwerke reservierte Kapazität und Rekonstruktionsleistung bereit. Das ausgefallene physische Laufwerk muss anschließend trotzdem ersetzt werden.

P

Paritätsstufe

dRAID1, dRAID2 und dRAID3 tolerieren je vdev einen, zwei oder drei gleichzeitige Laufwerksausfälle, solange ausreichend lesbare Redundanz vorhanden ist.

S

Verteilte Spare-Kapazität

Reserviert Laufwerksäquivalente als Recovery-Ziel über das vdev. Dadurch entsteht keine zusätzliche Paritätsstufe.

D

Datenspalten

Balancieren nominelle Kapazitätseffizienz und Zuordnungsverhalten. Breitere Gruppen können bei kleinen Blöcken mehr Kapazität verbrauchen.
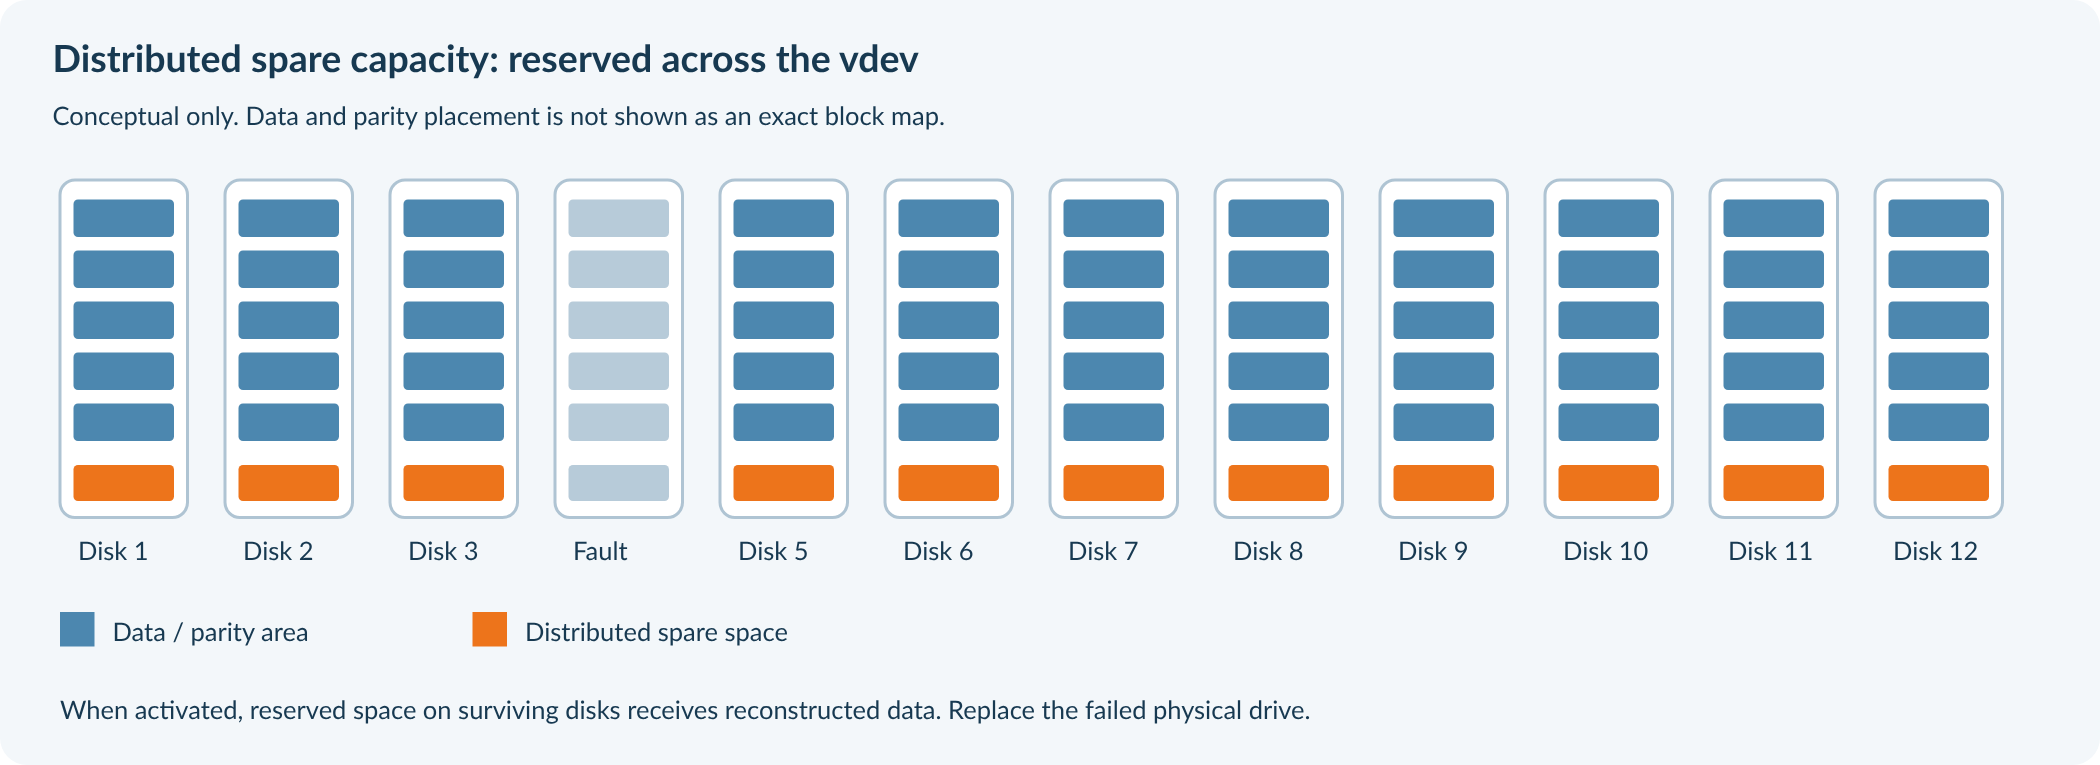
„Distributed“ bedeutet nicht Scale-out. dRAID verteilt Layout und Recovery-Aktivität innerhalb eines ZFS-vdev. Der Pool wird nicht über unabhängige Storage-Server kopiert.
Warum Unternehmen dRAID prüfen

Praktische Vorteile für großen lokalen Storage

Große Laufwerksbestände effizient nutzenEinfache, doppelte oder dreifache Parität zusammen mit geplanter Recovery-Kapazität wählen.
Einen einzelnen Recovery-Engpass vermeidenVerbleibende Laufwerke beteiligen sich an der Rekonstruktion, statt nur von der Schreibleistung eines einzelnen Spare-Laufwerks abzuhängen.
Das Betriebsmodell kompakt haltenEinen großen Pool in einem Server oder einem Shared-Storage-HA-System aufbauen, ohne einen mehrknotigen Scale-out-Cluster einzusetzen.
ZFS-Datendienste behaltenPrüfsummen, Scrubs, Datasets, Snapshots, Kompression und asynchrone Replikation rund um den Pool nutzen.
Konzeptionelle Darstellung verteilter Spare-Kapazität in einem dRAID-vdev
Architekturauswahl

dRAID, klassische ZFS-Layouts und Scale-out sind nicht austauschbar

dRAID kann deutlich einfacher und wirtschaftlicher sein, wenn Ausfallgrenzen und Wachstum zu einem Storage-System passen. Scale-out bleibt die stärkere Wahl, wenn unabhängige Knoten, horizontales Dienstwachstum oder ein verteiltes Standortdesign erforderlich sind.

Frage Mirror / RAIDZ dRAID Scale-out Storage
Grundmodell Ein ZFS-Pool aus klassischen vdevs. Ein ZFS-Pool mit einem großen verteilten RAID-vdev. Daten werden über unabhängige Storage-Knoten verteilt.
Typische Stärke Flexibles vdev-Design; Mirrors eignen sich häufig für zufällige I/O-Zugriffe. Große Kapazitäts-Repositories und verteilte Rekonstruktion. Horizontales Wachstum von Kapazität, Performance und Ausfallgrenzen.
Wachstumsgrenze Innerhalb des Servers oder Shared-Storage-Designs. Innerhalb des Servers oder Shared-Storage-Designs. Qualifizierte Knoten hinzufügen und Daten im Cluster neu verteilen.
Betriebsaufwand Kompakte Storage-Administration. Kompakte Storage-Administration mit zusätzlicher Geometrieplanung. Cluster-Netzwerk, Knotendienste und verteilter Betrieb.
Wirtschaftlich passende Anwendung Kleine bis mittlere Pools oder latenzsensitive Layouts. Große Kapazität in einem System, wenn Scale-out nicht benötigt wird. Umgebungen, die Knotenwachstum und verteilte Resilienz benötigen.
Fairer Vergleich: dRAID ist nicht „Ceph zum niedrigeren Preis“. Es handelt sich um eine andere Architektur. Die Einsparung entsteht, wenn das Projekt kein Scale-out-Verhalten benötigt und deshalb auf entsprechende Infrastruktur verzichten kann.
Eignung für Workloads

Kapazitätsorientierte Workloads sind der natürliche Ausgangspunkt

Gute KandidatenGroße Dateiarchive, Backup-Repositories, Mediensammlungen, Forschungsdaten und andere kapazitätsorientierte Workloads mit vorhersehbaren Zugriffsmustern.
Gezielt testenZufällige Small-Block-Workloads, virtuelle Maschinen, Datenbanken und stark komprimierbare Daten. Mirrors oder eine andere Geometrie können ein besseres Latenz- und Kapazitätsprofil liefern.

Mehr Laufwerke bedeuten nicht automatisch geringere Anwendungslatenz. Repräsentative Tests sollten Blockgröße, Dateigröße, Kompression, Pool-Belegung und gleichzeitige Client-Aktivität berücksichtigen.

Kapazitätsplanung

Parität, Spare-Kapazität und Datenbreite gemeinsam wählen

Der euroNAS-Assistent schätzt die Geometrie vor Metadaten, Zuordnungspadding, reserviertem Bereich und operativer Reserve. Die tatsächlich für Anwendungen nutzbare Kapazität fällt geringer aus.

(N − S) × D ÷ (D + P) × kleinstes Laufwerk
NAnzahl der ausgewählten Laufwerke.
SVerteilte Spare-Laufwerksäquivalente.
D + PDatenspalten plus Paritätsspalten je Redundanzgruppe.

Small-Block-Aspekt: dRAID verwendet Zuordnungen fester Breite. Kleine oder stark komprimierte Blöcke können deshalb mehr physischen Speicher belegen, als ihre logische Größe erwarten lässt. Der reale Workload sollte vor der endgültigen Geometriewahl getestet werden.
Premium und HA Cluster

Gleicher Laufwerksschutz, zwei Verfügbarkeitsmodelle

Standalone

euroNAS Premium

Ein Server besitzt und betreibt den dRAID-Pool. Dies ist das einfachste Modell für ein großes Kapazitäts-Repository ohne benötigte Controller-Redundanz.

  • dRAID1, dRAID2 oder dRAID3
  • Verteilte Spare-Kapazität
  • ZFS-Snapshots und asynchrone Replikation
  • Datei- und Block-Storage-Dienste
Shared-Storage-HA

euroNAS HA Cluster

Beide Controller greifen auf die gemeinsamen Laufwerke zu; genau einer besitzt den Pool mit Lese-/Schreibzugriff. Cluster-Richtlinien koordinieren die sichere Übernahme und abhängige Dienste.

  • dRAID1, dRAID2 oder dRAID3
  • HA stellt die Kontinuität bei Controller- oder Knotenausfall bereit
  • Client-Reconnect und Multipathing bleiben Teil des Designs
  • Replikation oder Backup liefern die unabhängige Recovery-Kopie
Mehrschichtige Resilienz

dRAID schützt Laufwerke – nicht jeden Fehler in der Umgebung

Laufwerksfehler

dRAID: rekonstruiert nicht verfügbare Daten innerhalb der gewählten Paritätstoleranz.

Controller-Ausfall

HA ergänzen: Die koordinierte Übernahme von Pool und Diensten erfordert HA Cluster.

Pool- oder Standortverlust

Replikation ergänzen: Asynchrone Übertragung hält eine getrennte Recovery-Kopie vor.

Löschung oder Angriff

Recovery-Richtlinie ergänzen: Snapshots, isolierte Backups und getestete Wiederherstellung bleiben unerlässlich.

Spezielle Geräte benötigen denselben Schutz: Metadaten- oder Special-Allocation-Geräte sind dauerhafte Bestandteile des Pools und keine entbehrlichen Caches. Sie brauchen ein redundantes, qualifiziertes Design und in einem HA-System Zugriff durch beide Controller.

dRAID anhand von Workload und Ausfallgrenzen bewerten

Kapazität, Latenz, Recovery-Zeit, künftiges Wachstum und Betriebsaufwand vor der Geometriewahl vergleichen.

Kapazitätswerte sind Planungsschätzungen. Tatsächlich nutzbare Kapazität und Recovery-Zeit hängen von Geometrie, Laufwerksgröße, Workload, Metadaten, Zuordnungsverhalten, freiem Arbeitsbereich und der installierten euroNAS-Version ab. dRAID, HA, Replikation und Backup sind getrennte Schutzebenen.

Nach oben scrollen