S3 Site Replication
AktualisiertMit ameEKAS 8. Oktober 2026 anhand der aktuell evaluierten Oberfläche. Die Screenshots zeigen die englische Benutzeroberfläche einer Testinstallation. Ersetzenkönnen Sie BeispielnamenS3-Daten zwischen Standorten replizieren, auf eine andere S3-Instanz spiegeln und Adressenin einem externen Backup archivieren. Dieses Kapitel führt Sie durch IhreEinrichtung, eigenenÜberwachung Werte.und DieWiederherstellung englischenund Schaltflächenbezeichnungenhilft erleichternIhnen, diedas Zuordnung.passende Schutzverfahren auszuwählen.
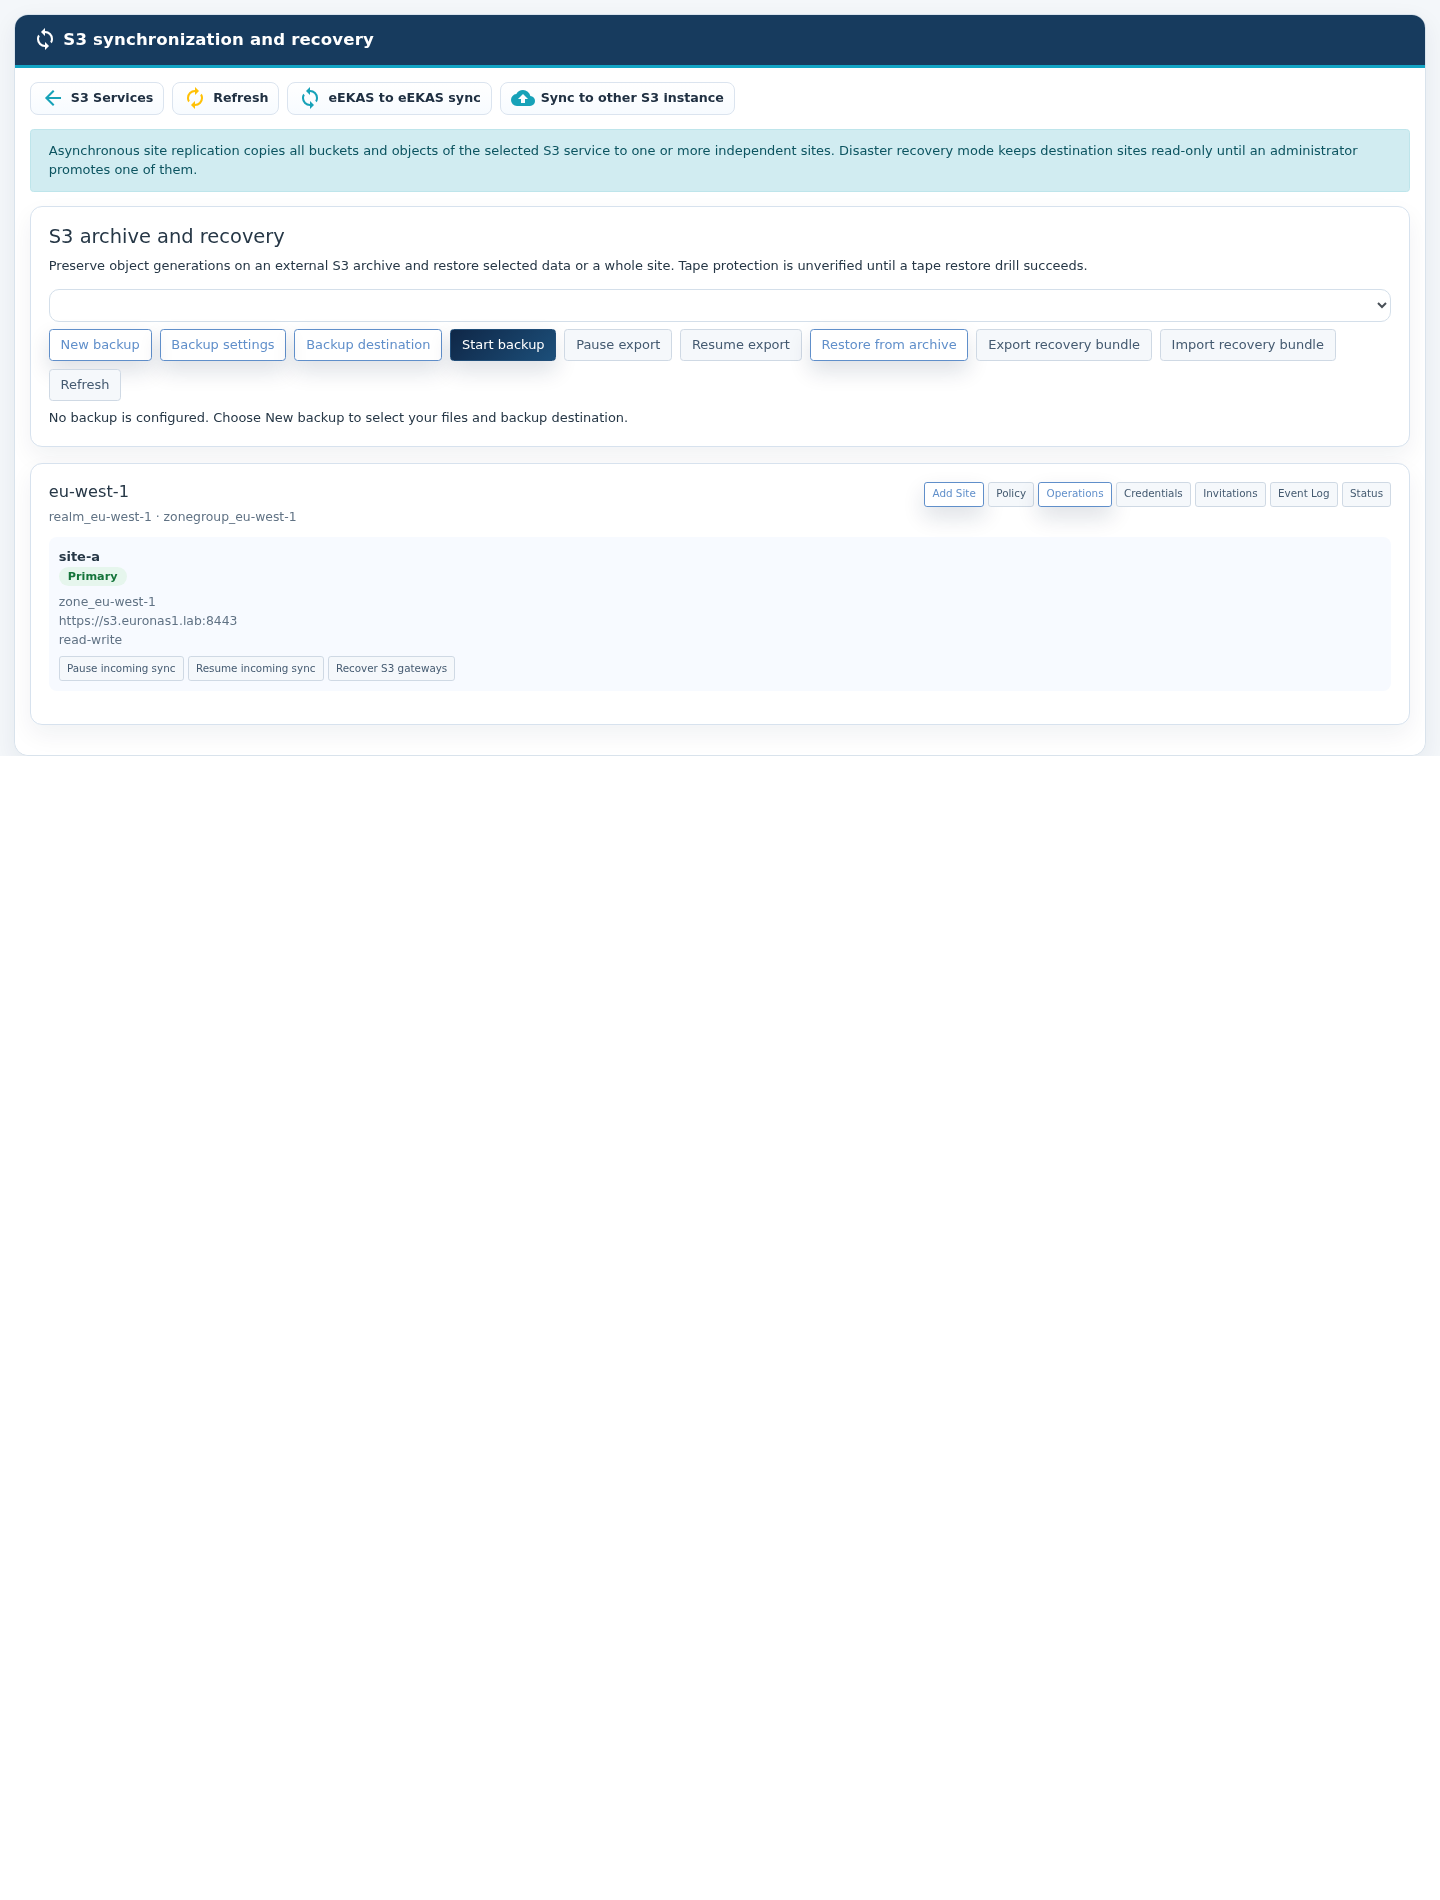
Schutzverfahren auswählen
| Verfahren | Zweck |
|---|---|
| eEKAS to eEKAS sync | Asynchrone native Standortreplikation: schreibgeschütztes Disaster-Recovery-Ziel oder Active-Active mit Schreibzugriffen. |
| Mirror current objects | Einwegkopie aktueller Objekte auf eine andere S3-Instanz, ohne Wiederherstellung anhand von Checkpoints. |
| Backup and archive | Aufbewahrte Objektgenerationen und veröffentlichte Wiederherstellungspunkte mit Vorschau und Restore. |
Standortreplikation überträgt Änderungen und ersetzt kein unabhängiges Backup. Der Metadaten-Primärstandort verwaltet die administrativen Metadaten; er ist nicht zwingend der einzige Standort mit Objektschreibzugriffen.
1. Voraussetzungen und Vorbereitung
- Verwenden Sie gesunde unabhängige Cluster mit kompatiblen, abgenommenen eEKAS-Versionen. Planen Sie Kapazität für Replikate, aufbewahrte Versionen und das Aufholen von Rückständen.
- Konfigurieren Sie jeden S3-Dienst mit lokalem Speicher, IP-Gruppe, geeigneten Gateway-Knoten, stabilem DNS und vertrauenswürdigen HTTPS-Zertifikaten. Prüfen Sie Routing, Firewall, Zeitsynchronisation und Erreichbarkeit.
- Für den nativen Beitritt muss der S3-Zieldienst vollständig leer sein, ohne Buckets. Der Beitritt übernimmt diesen Dienst; bestehende gefüllte Namensräume werden nicht zusammengeführt.
- Aktivieren Sie für Online-Einladungen die REST API der Quelle. Das Ziel muss deren Management-HTTPS-Listener erreichen, normalerweise Port 18443.
- Dokumentieren Sie Versionierung, Object Lock, Aufbewahrung, Legal Holds, Berechtigungen und SMB-Gateway-Konfiguration. Legen Sie Wiederherstellungsverantwortung, Isolation des alten Primärstandorts, Client-Umleitung, RPO und RTO fest.
- Der ausgewählte Backup-Worker benötigt Zugriff auf Quelle und Archiv sowie genügend lokalen Staging-Speicher.
Lassen Sie die Zertifikatsprüfung aktiviert und konfigurieren Sie bei Bedarf das Vertrauen in die private CA. Die Annahme eines nicht vertrauenswürdigen Zertifikats ist eine ausdrückliche Ausnahme für kontrollierte private Systeme.
2. Native eEKAS-Replikation einrichten
Quellinstallation konfigurieren
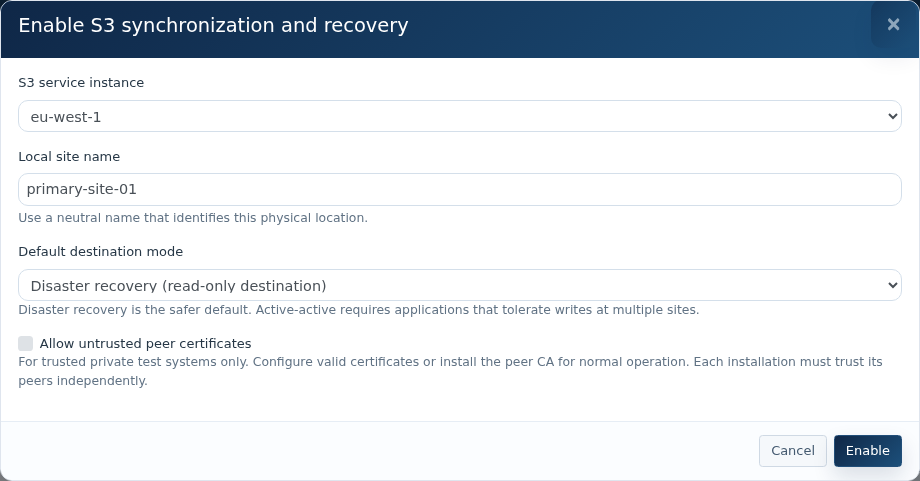
- Öffnen Sie S3 synchronization and recovery → eEKAS to eEKAS sync → Set up source installation.
- Wählen Sie den S3-Quelldienst und geben Sie einen Namen für den physischen Standort ein.
- Wählen Sie Disaster recovery (read-only destination). Verwenden Sie Active-active (writes allowed at every site) nur, wenn die Anwendungen gleichzeitige asynchrone Schreibzugriffe tolerieren.
- Lassen Sie die Zertifikatsprüfung zwischen den Standorten aktiv. Wählen Sie Enable und warten Sie auf die Beziehung. Active-Active verlangt die Bestätigung möglicher Schreibkonflikte.
Einmalige Einladung erstellen
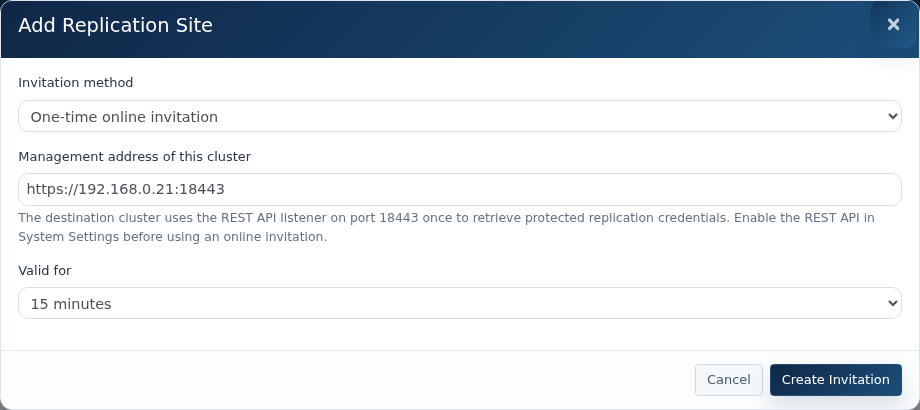
- Wählen Sie an der Quelle Add Site und eine einmalige Online-Einladung.
- Tragen Sie die vom Ziel erreichbare Managementadresse der Quelle ein, normalerweise HTTPS-Port 18443.
- Wählen Sie 15 Minuten, 60 Minuten oder 24 Stunden Gültigkeit. Erstellen und übertragen Sie das Token sicher.
- Lösen Sie es vor Ablauf ein. Prüfen Sie Invitations und widerrufen Sie ungenutzte gültige Einladungen.
Die verschlüsselte Einladungsdatei benötigt eine Passphrase mit mindestens 12 Zeichen. Übertragen Sie Datei und Passphrase getrennt. Das aktuelle Ziel-Webformular akzeptiert Online-Adresse und Token; klären Sie vor Verwendung der Datei das unterstützte administrative Importverfahren.
Leeren Zielstandort verbinden
- Öffnen Sie am Ziel eEKAS to eEKAS sync → Connect this installation.
- Wählen Sie einen leeren lokalen S3-Dienst und einen eindeutigen Standortnamen. Dessen Speicher, IP-Gruppe und Gateways werden für das Replikat verwendet.
- Geben Sie Quell-Managementadresse und einmaliges Token ein. Konfigurieren Sie gegebenenfalls vertrauenswürdige CA-Daten.
- Wählen Sie den Zielmodus und Validate and Join. Prüfen Sie den Endpunkt und bestätigen Sie die Übernahme des leeren Dienstes.
- Warten Sie auf Einrichtung und initiale Synchronisierung. Prüfen Sie beide Installationen und lesen Sie Testobjekte über die tatsächlichen S3-Endpunkte. Im DR-Modus müssen Schreibzugriffe am Ziel abgewiesen werden.
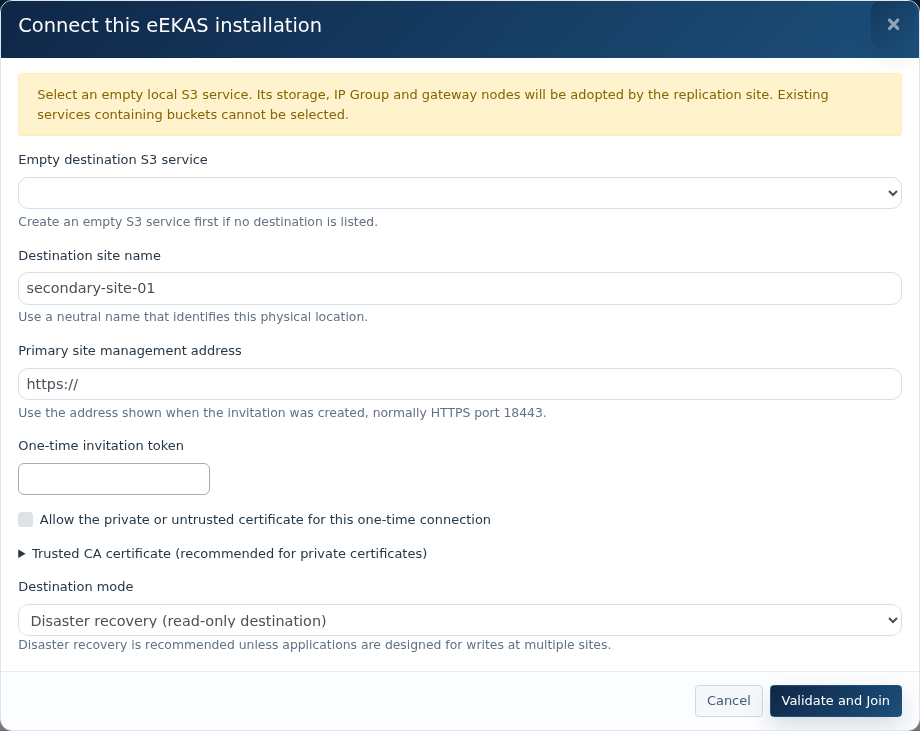
Prüfen Sie bei Fehlern die Rückmeldung und das Event Log. Eine teilweise abgeschlossene Einrichtung kann administrative Bereinigung erfordern. Löschen Sie keine Replikat-Pools oder aufbewahrten ursprünglichen Speicherbereiche, um einen Namensfehler zu beheben.
3. Richtlinien und täglicher Betrieb
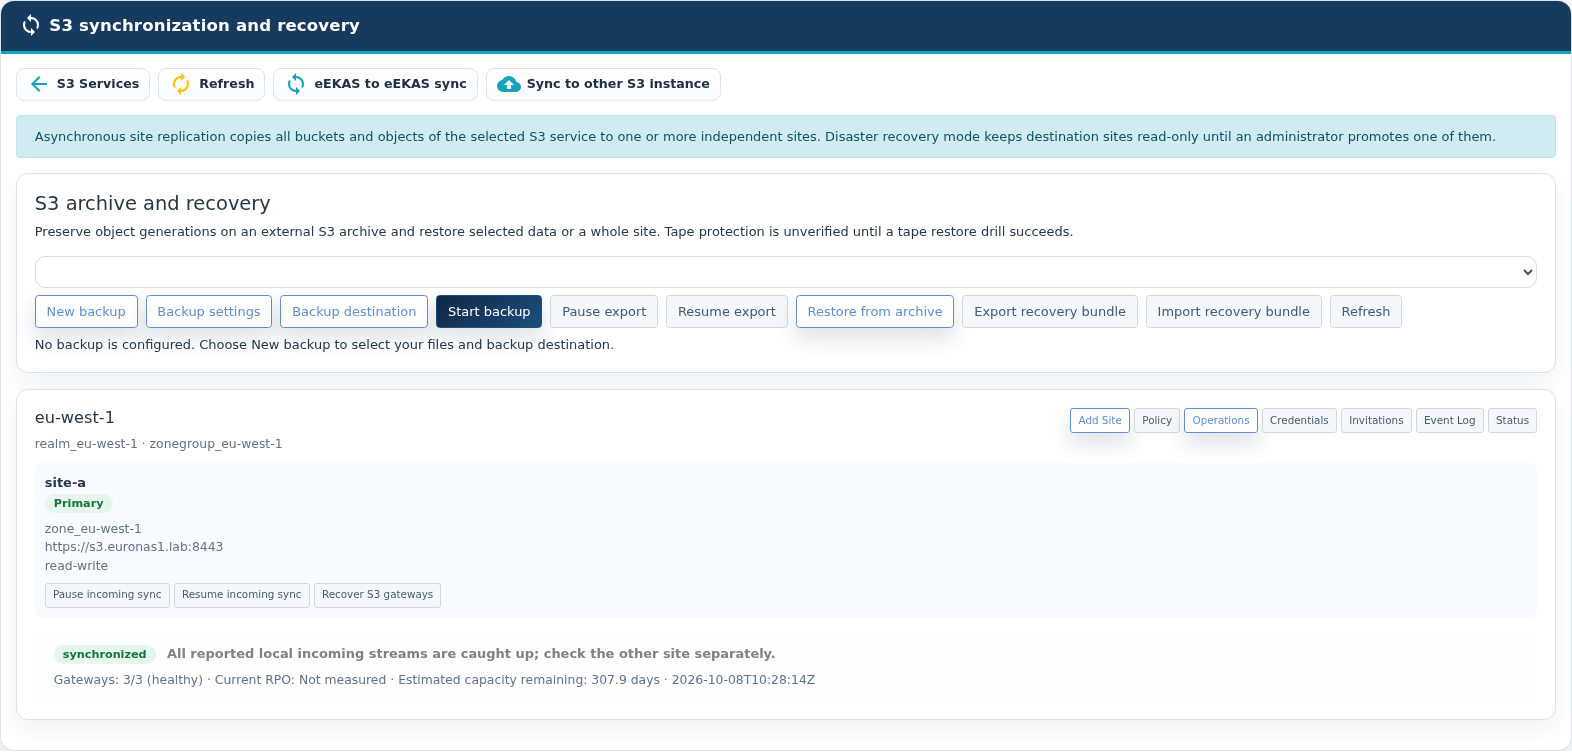
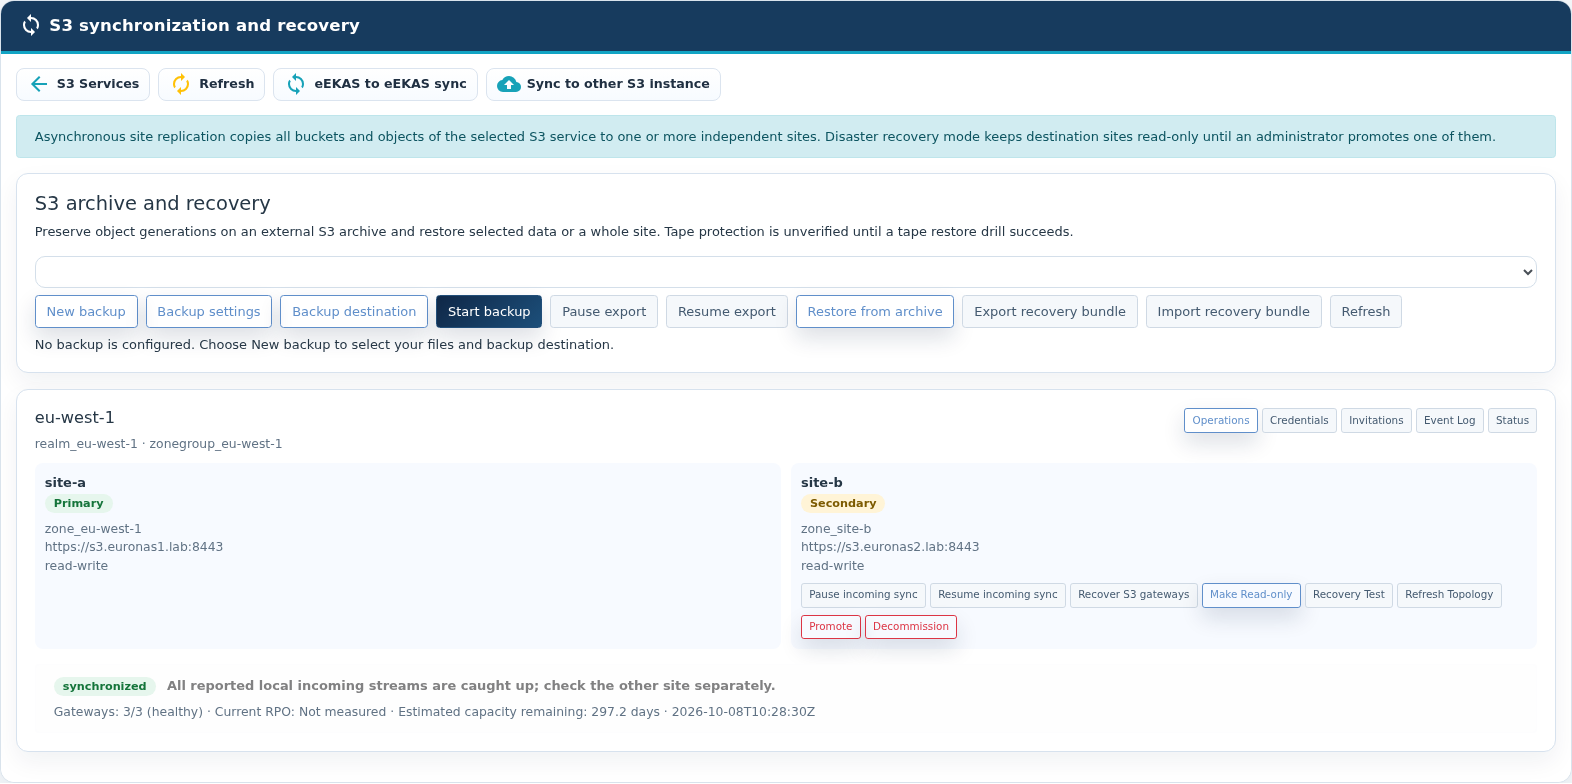
In der evaluierten Quelle erscheint die lokale Standortkarte, am Ziel erscheinen beide Karten. Anzahl und Beschriftung Primary/Secondary beweisen keinen vollständigen Zustand des Gegenstandorts. Lesen Sie Synchronisierungsstatus und Gateway-Anzahl auf jeder Installation.
| Einstellung | Bedeutung |
|---|---|
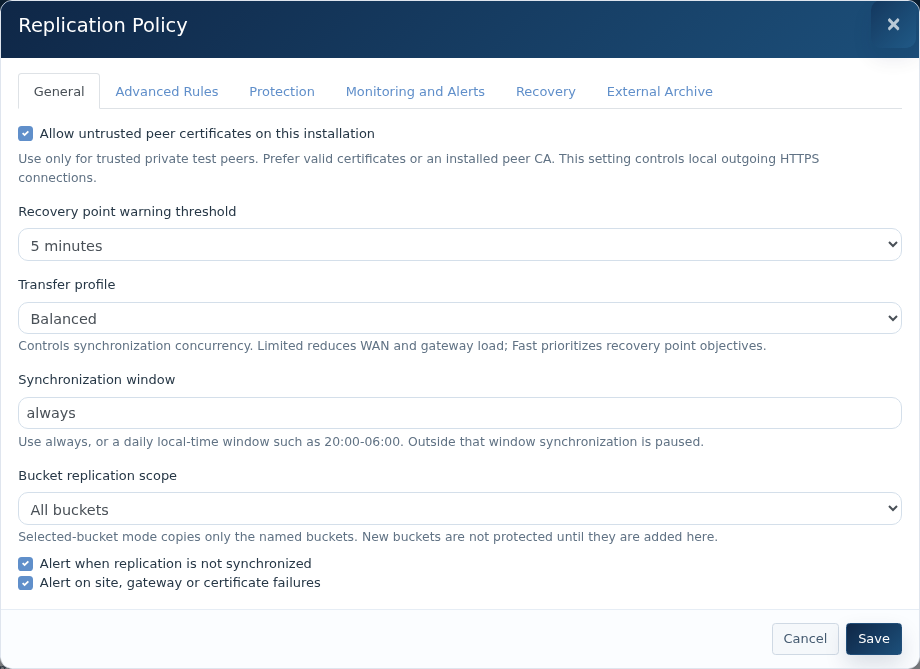
| Recovery point warning threshold | 5, 15 oder 60 Minuten oder 24 Stunden: Warnziel, keine synchrone Replikation oder garantierte RPO. Die tatsächliche Dauerhaftigkeits-RPO ist weiterhin ungemessen. |
| Transfer profile | Limited, Balanced und Fast ändern die Parallelität, nicht eine feste Bandbreitenbegrenzung. |
| Synchronization window | Immer oder tägliches Zeitfenster in lokaler Zeit, z. B. 20:00–06:00. Außerhalb pausiert die Synchronisierung; der Rückstand kann wachsen. |
| Bucket replication scope | Alle Buckets oder ausgewählte Namen, getrennt durch Semikolons. Nicht gelistete und neue Buckets bleiben ausgeschlossen, bis sie ergänzt werden. |
| Advanced Rules | Bucket-, Schlüsselpräfix- und Tagfilter, Zuordnung von Zielbucket, Eigentümer und Speicherklasse sowie Einweg-/Zweiwegrichtung. Ersetzt die einfache Auswahl; Routing testen. |
| Protection | Löschverhalten, Versionierung und Object Lock gemeinsam prüfen. Frühere Versionen benötigen Versionierung; externe Löschverzögerung und Kopierschutz betreffen den externen Transferpfad. |
| Monitoring and Alerts | E-Mail, bestehende SNMP-Meldungen, Webhook-Zustandsänderungen oder Prometheus. Zustellung testen. |
| Recovery | Validierung, sichere administrative Recovery-Hooks und optionale globale Endpunktintegration. Bei manueller Umleitung muss ein Administrator das Routing ändern. |
| External Archive | Zeitgesteuerte Kopie/Spiegelung aktueller Objekte. Backup mit aufbewahrten Generationen wird separat unter S3 archive and recovery eingerichtet. |
Status richtig auswerten
Synchronized bedeutet, dass die gemeldeten lokalen eingehenden Streams aufgeholt haben. Dies bestätigt weder die Gegenrichtung noch Datenverlustfreiheit oder ein physisches Medienbackup. Prüfen Sie beide Standorte. Syncing/behind erfordert Nachverfolgung, error zeigt ein Problem und unknown bedeutet fehlende Nachweise.
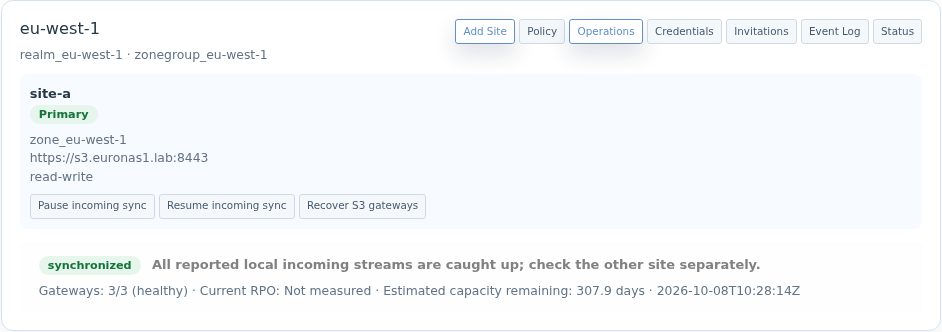
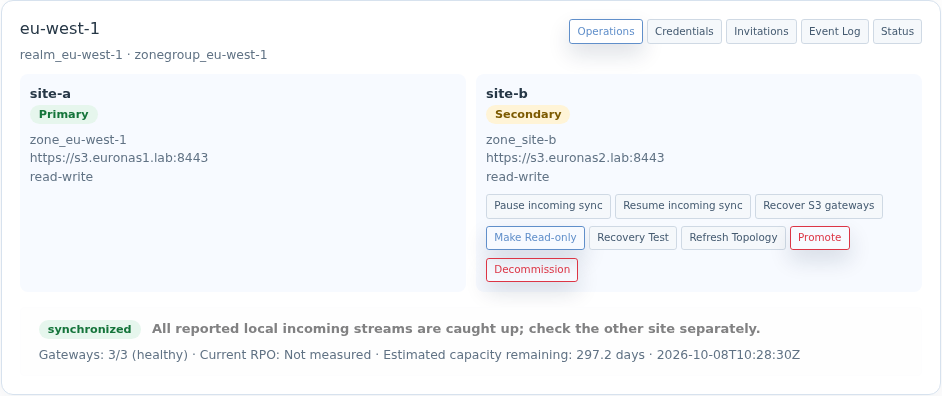
- Verwenden Sie Refresh und prüfen Sie Endpunkte, Modi, Gateways und Event Log.
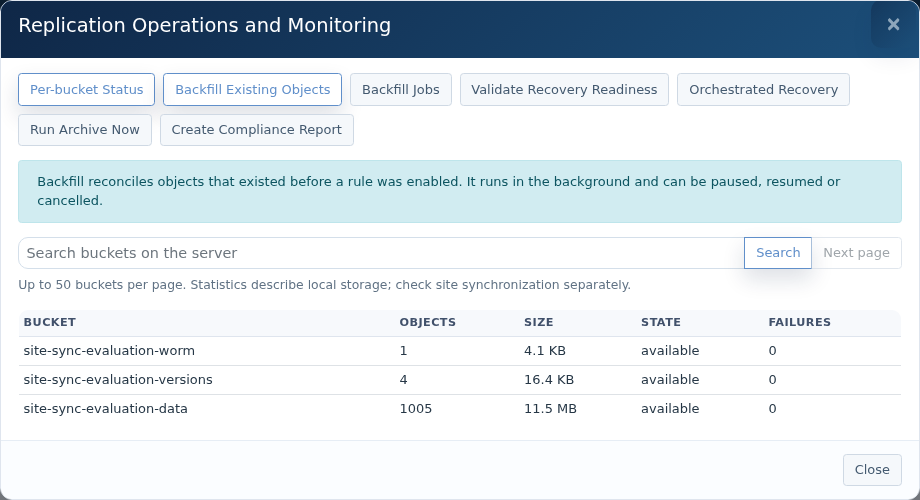
- Operations zeigt lokale Bucket-Statistiken mit Search und Next page, maximal 50 Einträge je Seite. Die Zähler verifizieren keinen entfernten Objektbestand.
- Pause/Resume betrifft die lokale eingehende Synchronisierung. Bei Active-Active werden damit nicht automatisch ausgehende oder entfernte Streams pausiert.
- Allow Writes und Make Read-only am jeweiligen Sekundärstandort ändern den Schreibmodus; prüfen Sie danach Synchronisierung und Anwendungen.
Bestandsobjekte, Schlüsselrotation und Entfernen
Starten Sie am Ziel Backfill Existing Objects für Objekte, die vor der Aktivierung einer Regel existierten. Verfolgen Sie Backfill Jobs und nutzen Sie Pause, Resume oder Cancel. Planen Sie Backfill als eigene Lastphase und prüfen Sie anschließend Bytes und Versionen.
Schlüsselrotation: Stage Replacement am Primärstandort → Adopt Replacement an jedem Sekundärstandort → Activate Replacement am Primärstandort → Finalize Rotation erst bei gesunder Synchronisierung. Der bisherige Schlüssel bleibt bis zum Abschluss gültig.
Das Entfernen aus der Primärtopologie ist vom lokalen Stilllegen des entfernten Standorts getrennt. Lokale Stilllegung stoppt Gateways und entfernt die Replikatkonfiguration. Daten bleiben erhalten, sofern ihre Löschung nicht ausdrücklich gewählt und bestätigt wird. Prüfen Sie vorher die Wiederherstellungsalternativen.
4. Wiederherstellung der nativen Replikation
S3-Gateways wiederherstellen
Ist der Endpunkt einer laufenden Installation nicht erreichbar, prüfen Sie Gateways, Netzwerk und IP-Gruppe. Recover S3 gateways startet lokale Gateway-Dienste neu und aktualisiert Endpunktressourcen. Prüfen Sie Ergebnis, echte S3-Lese-/Schreibzugriffe und das Aufholen. Dies rekonstruiert keinen verlorenen Clusterspeicher und stuft keinen Sekundärstandort hoch.
Standby-Standort hochstufen
- Legen Sie den künftigen maßgeblichen Standort und den letzten replizierten Datenstand fest. Stoppen Sie während der Entscheidung nach Möglichkeit Anwendungsschreiben.
- Stoppen oder isolieren Sie den alten Primärstandort und bestätigen Sie das Fencing, damit er nicht unabhängig wieder maßgeblich werden kann.
- Prüfen Sie eingehende Synchronisierung, Gateways und Endpunkt des überlebenden Standorts. Starten Sie Validate Recovery Readiness unter Operations.
- Wählen Sie Promote oder die konfigurierte Orchestrated Recovery, das Ziel und den angezeigten Zonennamen zur Bestätigung. Bestätigen Sie die Isolation des Primärstandorts.
- Verwenden Sie erzwungene Notfalloptionen nur nach ausdrücklicher Annahme und Dokumentation möglicher Verluste neuer Objekte.
- Ändern Sie Client-Routing manuell oder über eine getestete globale Endpunktintegration. Prüfen Sie Daten, Berechtigungen, WORM und Anwendungszugriff.
- Halten Sie den zurückkehrenden alten Primärstandort isoliert. Aktualisieren und bereinigen Sie die Topologie, synchronisieren Sie ihn und planen Sie erst dann Schreibfreigabe oder Failback.
Hooks und DNS-/Load-Balancer-Integration benötigen sichere Programme und getestete Konfiguration. Ein Hostname allein bewirkt keinen automatischen Failover. Active-Active-Schreibzugriffe am überlebenden Standort lösen den Verlust des Metadaten-Primärstandorts nicht. Vollständiger Primärclusterverlust und komplette Promotion/Failback wurden in der dokumentierten Evaluation nicht durchgeführt.
5. Aktuelle Objekte auf eine andere S3-Instanz spiegeln
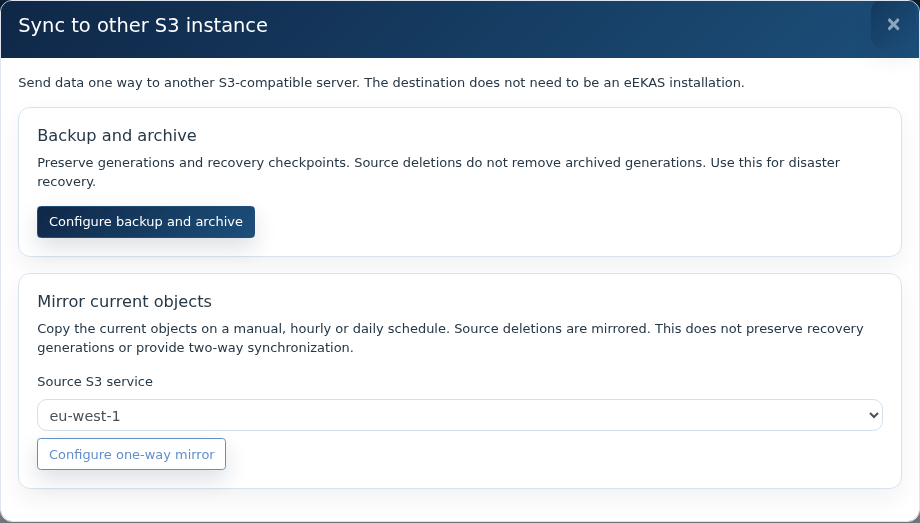
- Öffnen Sie an der Installation des Metadaten-Primärdiensts Sync to other S3 instance → Mirror current objects, wählen Sie den Quelldienst und Configure one-way mirror.
- Aktivieren Sie in External Archive das Ziel und tragen Sie Name, HTTPS-Endpunkt, vorhandenen Bucket, Signaturregion, Access Key und Secret ein.
- Mirror überträgt aktuelle Inhalte und Quelllöschungen. Copy only belässt zusätzliche Zielobjekte. Wählen Sie Manual, Hourly oder Daily.
- Prüfen Sie Protection, Löschverzögerung, geschütztes Archiv, Quellauswahl und Regeln. Speichern Sie.
- Manueller Lauf: Operations → Run Archive Now. Prüfen Sie Ergebnis und Event Log sowie Zielbytes, Überschreiben und Löschverhalten in Testbuckets.
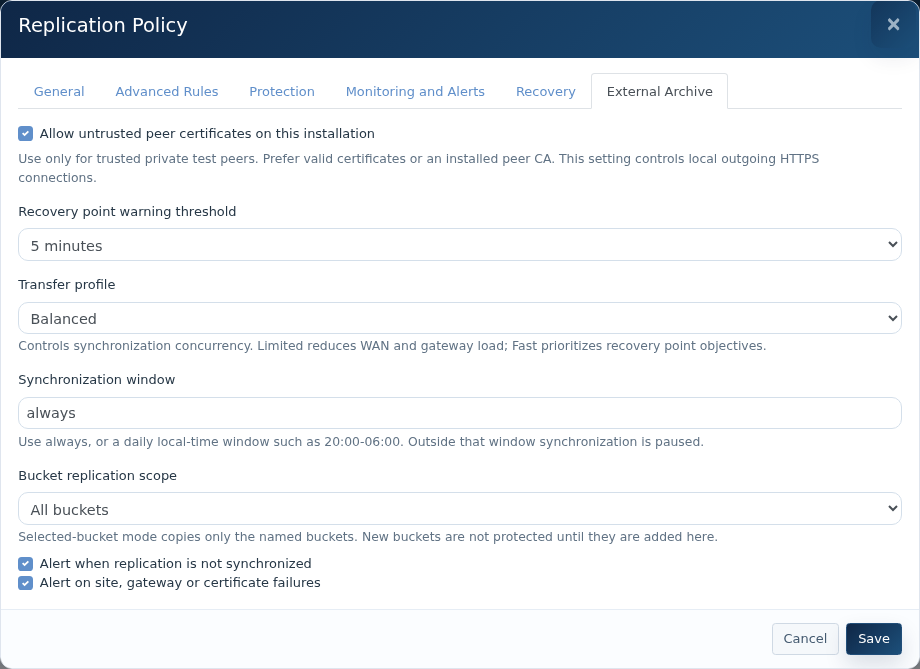
Jeder Quellbucket verwendet ein gleichnamiges Präfix im Zielbucket. Es gibt keine Rücksynchronisierung, Checkpoint-Vorschau/-Wiederherstellung, Rekonstruktion ursprünglicher Versionen oder Eigentümerwiederherstellung. Copy only kann vorhandene Zielschlüssel überschreiben. Der Bereich für verzögerte Löschungen ist kein Wiederherstellungskatalog. Halten Sie fremde Inhalte außerhalb der verwalteten Präfixe. Prüfen Sie bei großen Buckets Listing-Dauer und Worker-Speicher. Die neue vollständige Abnahme an einem unabhängigen externen Mirror-Ziel steht noch aus.
6. Backup und Archiv einrichten
- Wählen Sie Sync to other S3 instance → Configure backup and archive oder New backup unter S3 archive and recovery.
- Geben Sie einen eindeutigen Backupnamen, externe HTTPS-Adresse, vorhandenen Zielbucket und Zugangsschlüssel ein.
- Wählen Sie die Quellzone. Whole zone umfasst heutige und künftige Buckets. Individual buckets öffnet Available buckets und Selected for backup.
- Suchen und ergänzen Sie Buckets. Die Auswahl bleibt über Suche/Seitenwechsel erhalten. Add this page ergänzt nur die sichtbare Seite, Remove entfernt eine Auswahl.
- Wählen Sie Standard backup (recommended) oder die geplante Option Extra protection for older versions.
- Wählen Sie unter Run this backup on den ausführenden eEKAS-Knoten. Erstellen Sie das Backup über dessen Managementseite und prüfen Sie Netzwerk und Staging-Speicher.
- Prüfen Sie erweiterte Einstellungen, wählen Sie Save backup und anschließend Start backup. Speichern startet keinen Export. Warten Sie auf einen abgeschlossenen Checkpoint.
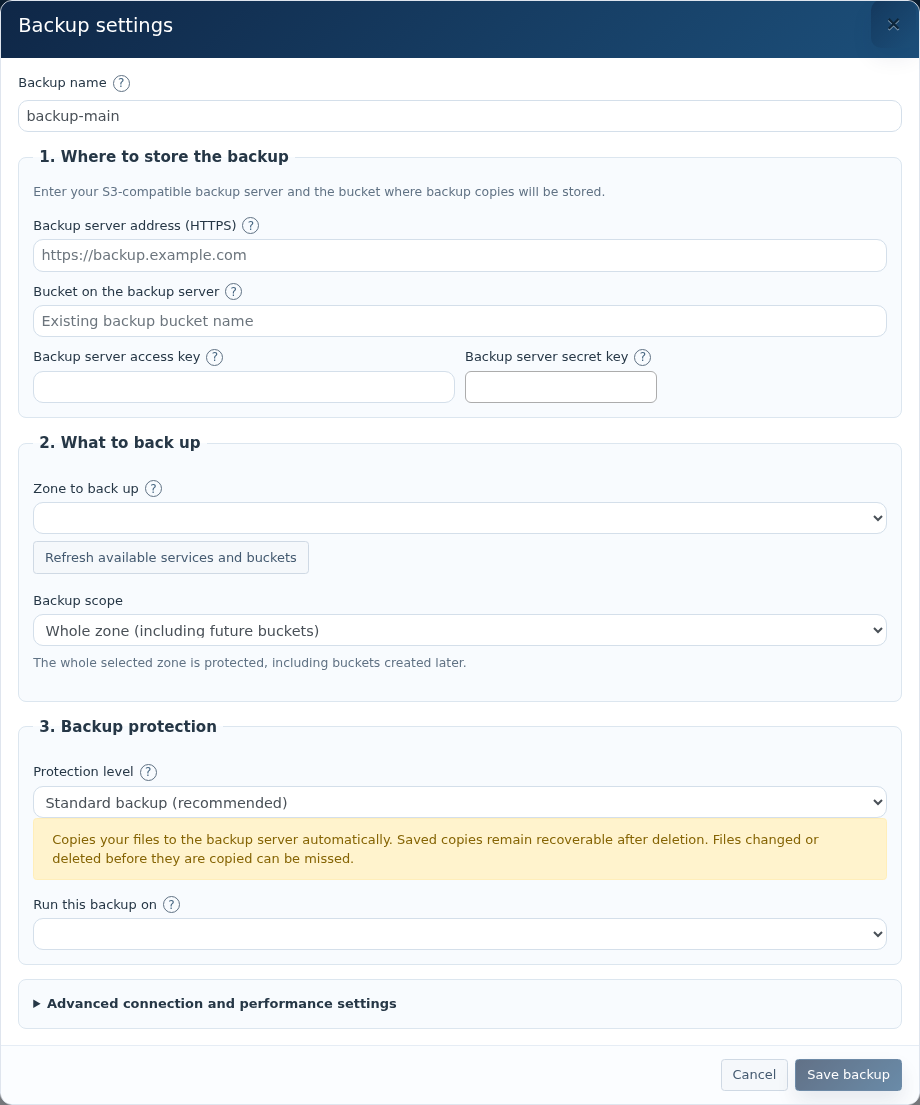
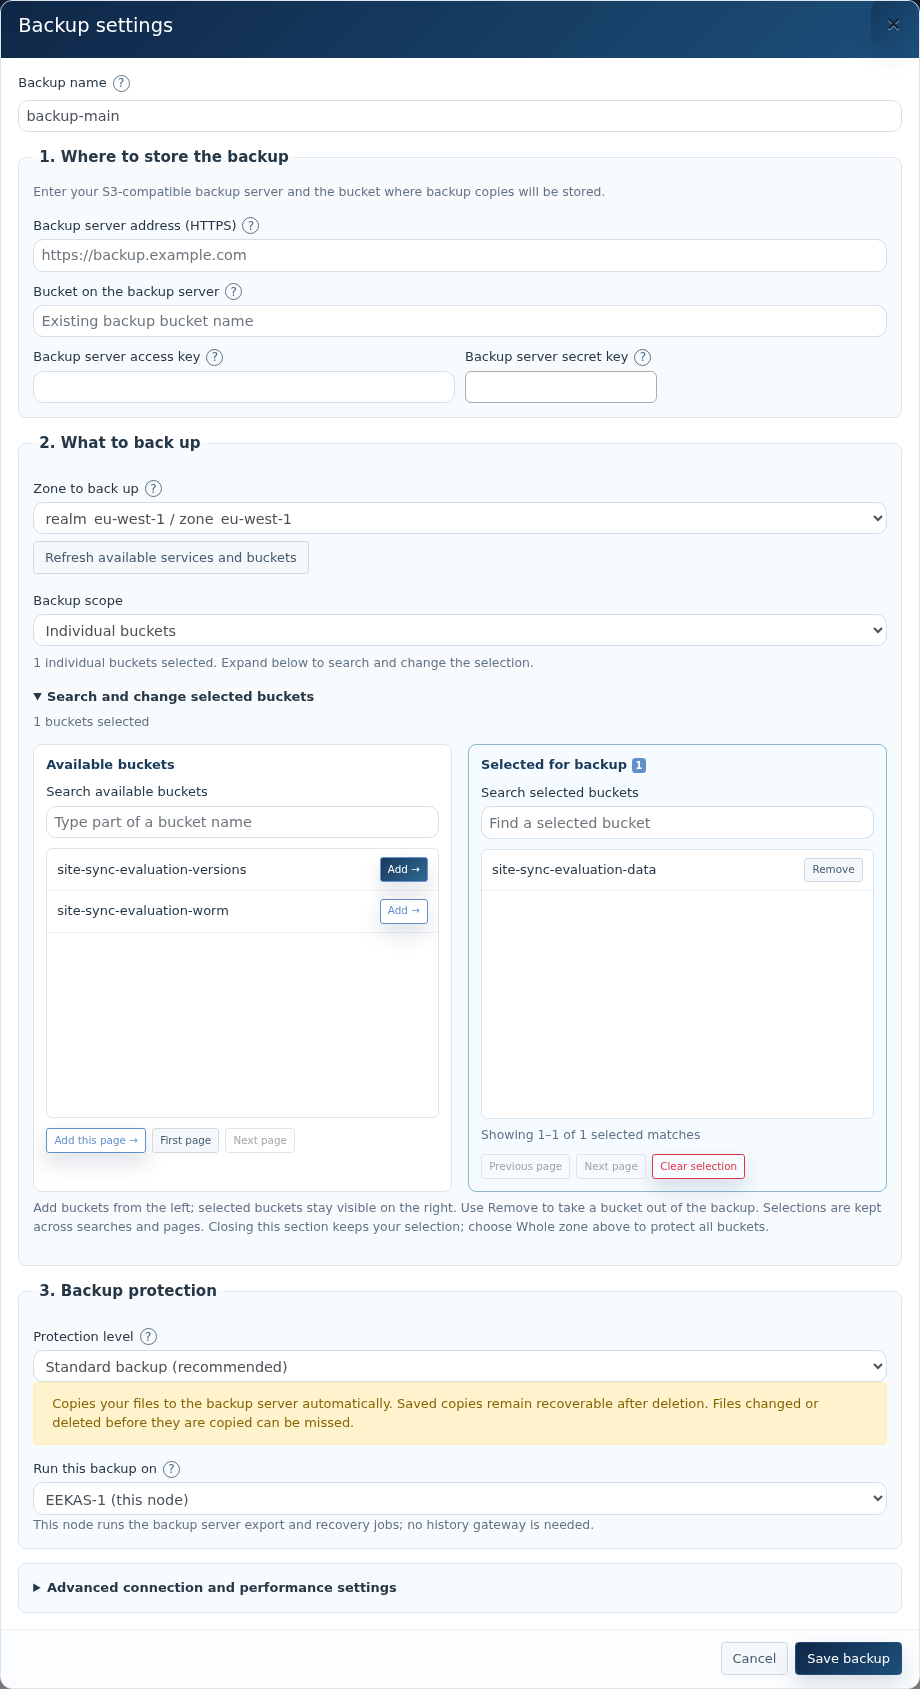
Standard backup liest noch verfügbare Quellgenerationen. Eine bereits vor dem Lesen entfernte Version kann es nicht sichern. Behalten Sie Quellversionierung und WORM bei. Extra protection erstellt eine lokale History-Zone mit eigenem Gateway, freiem Port (z. B. 9443), HTTPS-Endpunkt, Zertifikat/privatem Schlüssel und Speicher. Dies benötigt zusätzliche Kapazität; lokale History-Kopien allein überleben keinen vollständigen Verlust der Primärinstallation.
| Erweiterte Einstellung | Standard / Verwendung |
|---|---|
| Source service details / CA | Ermittelte Werte für Realm, Zonegroup, Zone und Endpunkt beibehalten, sofern keine begründete Änderung nötig ist. Private CA-Kette bei Bedarf angeben. |
| Check for changes every | 60 Sekunden; Uploadmeldungen können früher Arbeit einreihen. Keine garantierte Exportlatenz. |
| Minimum time between full recovery catalogs | 3.600 Sekunden. Katalogdauer vor Verkürzung messen. |
| Parallel WORM protection checks | 4. Metadatenprüfungen sind von Uploads getrennt; Quellanfragelast beobachten. |
| Recheck WORM settings after | 3.600 Sekunden gewünschtes Minimum; große Warteschlangen können länger benötigen. |
| Largest file to stage locally | 100 GiB je Objekt, keine Gesamtspeicherreservierung. Tatsächlichen freien Speicher vorhalten. |
| Backup server S3 region | Üblicherweise us-east-1; Signaturregion des Ziels verwenden. |
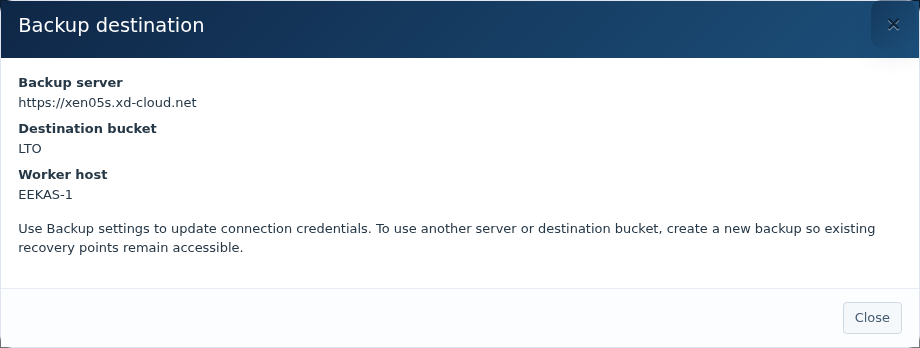
Prüfen und ändern Sie Verbindungseinstellungen über Backup settings. Bei Änderungen der Speicheridentität, Schutzstufe oder geschützten Bucketauswahl erstellen Sie ein neues Backup und behalten alte Wiederherstellungspunkte zugänglich.
7. Export überwachen und Wiederherstellungsinformationen sichern
Wählen Sie das Backup und Refresh. Zustände unterscheiden Starting backup, Copying files, Checking source files, Creating recovery point und Up to date — watching for changes. Prüfen Sie Worker-Heartbeat, Fehler/Wiederholungen, gespeicherte/wartende Objekte und letzten abgeschlossenen Checkpoint. Bei Worker unavailable prüfen Sie den ausgewählten Knoten. Inventarisierung läuft weiter, wenn Uploadmeldungen nicht korrekt registriert sind.
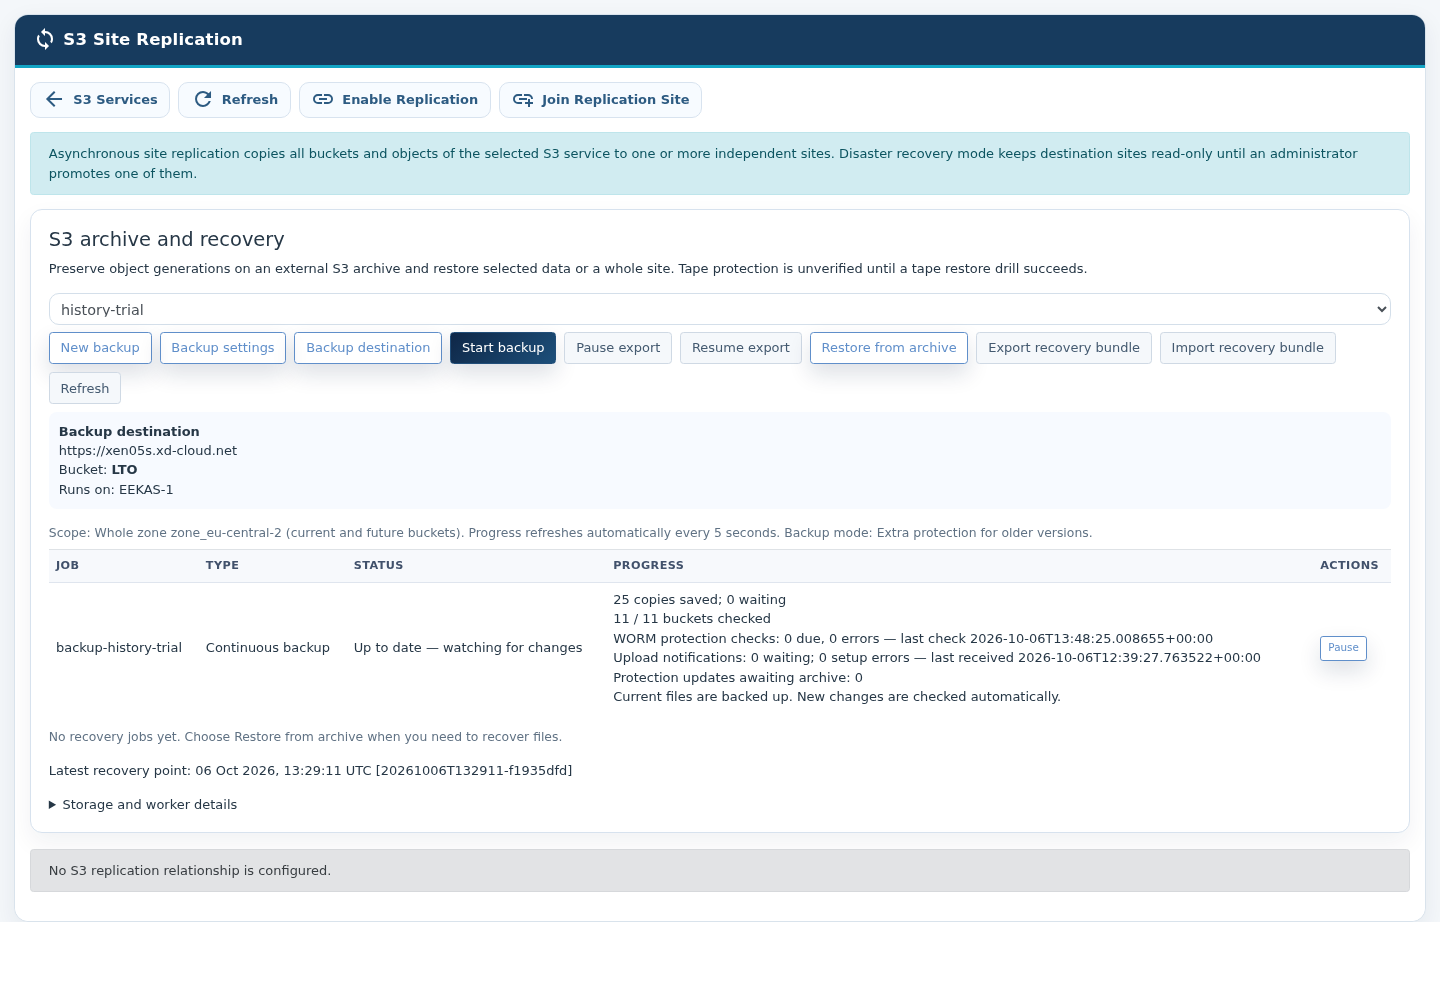
Pause export beendet die laufende Arbeit vor dem Stoppen; Resume export setzt fort. Bereits exportierte Objekte gehören erst nach Abschluss des nächsten vollständigen Katalogs zu einem unterstützten Wiederherstellungspunkt. Kopierbestätigung und leere Warteschlange beweisen keinen Abschluss oder Nachweis physischer Bandsicherung.
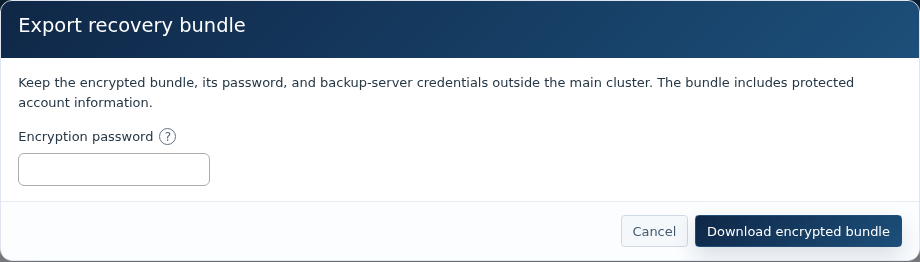
- Wählen Sie Export recovery bundle.
- Verwenden Sie ein Verschlüsselungskennwort mit mindestens 16 Zeichen und laden Sie das Bundle herunter.
- Bewahren Sie Bundle, Kennwort und Archivzugang außerhalb des Primärclusters auf. Halten Sie das Kennwort getrennt von der Datei und schützen Sie alles wie Zugangsdaten.
- Aktualisieren Sie die Informationen nach Konfigurationsänderungen und üben Sie den Import auf einem isolierten Ersatzsystem.
8. Checkpoint wiederherstellen
- Bereiten Sie einen funktionierenden Ersatz-S3-Dienst und Zugangsdaten zum Erstellen, Lesen und Schreiben von Recovery-Buckets vor. WORM benötigt passende Schutzoperationen am Ziel.
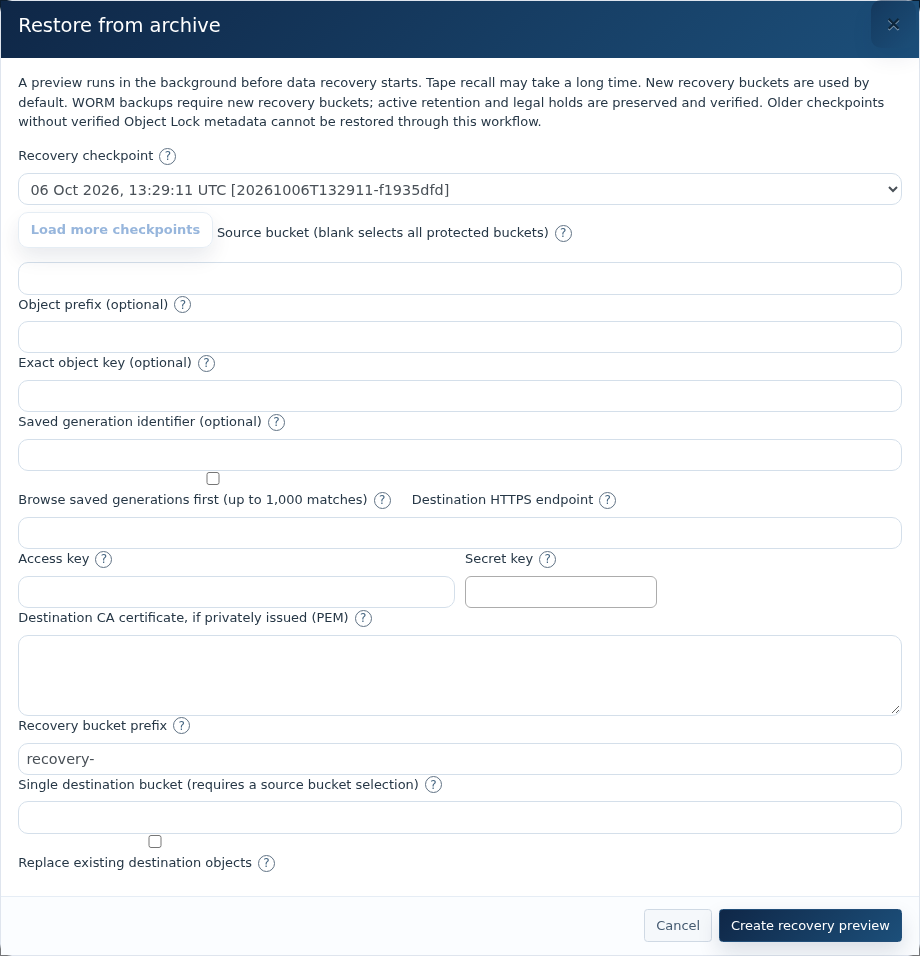
- Wählen Sie Restore from archive und einen abgeschlossenen Checkpoint anhand des UTC-Datums. Die ursprüngliche Kennung steht in Klammern. Laden Sie bei Bedarf weitere Einträge.
- Lassen Sie Source bucket für alle geschützten Buckets leer oder filtern Sie nach Bucket, wörtlichem Präfix oder genauem Objektschlüssel. Präfix ist kein Platzhalter. Browse saved generations ermöglicht ältere Kopien; die Vorschau ist auf 1.000 Treffer begrenzt.
- Tragen Sie Ziel-HTTPS-Endpunkt, Zugangsdaten und gegebenenfalls private CA-Kette ein. Verwenden Sie ein separates Bucketpräfix, z. B. recovery-. Ein einzelner Zielbucket setzt einen ausgewählten Quellbucket voraus.
- Lassen Sie Überschreiben vorhandener Objekte deaktiviert, sofern es nicht für ungeschützte Daten benötigt wird. WORM-Restore verlangt unabhängig davon neue Buckets.
- Erstellen Sie die Recovery-Vorschau. Prüfen Sie Anzahl, Konflikte, nicht verfügbare Generationen und Schutzinformationen vor dem Start.
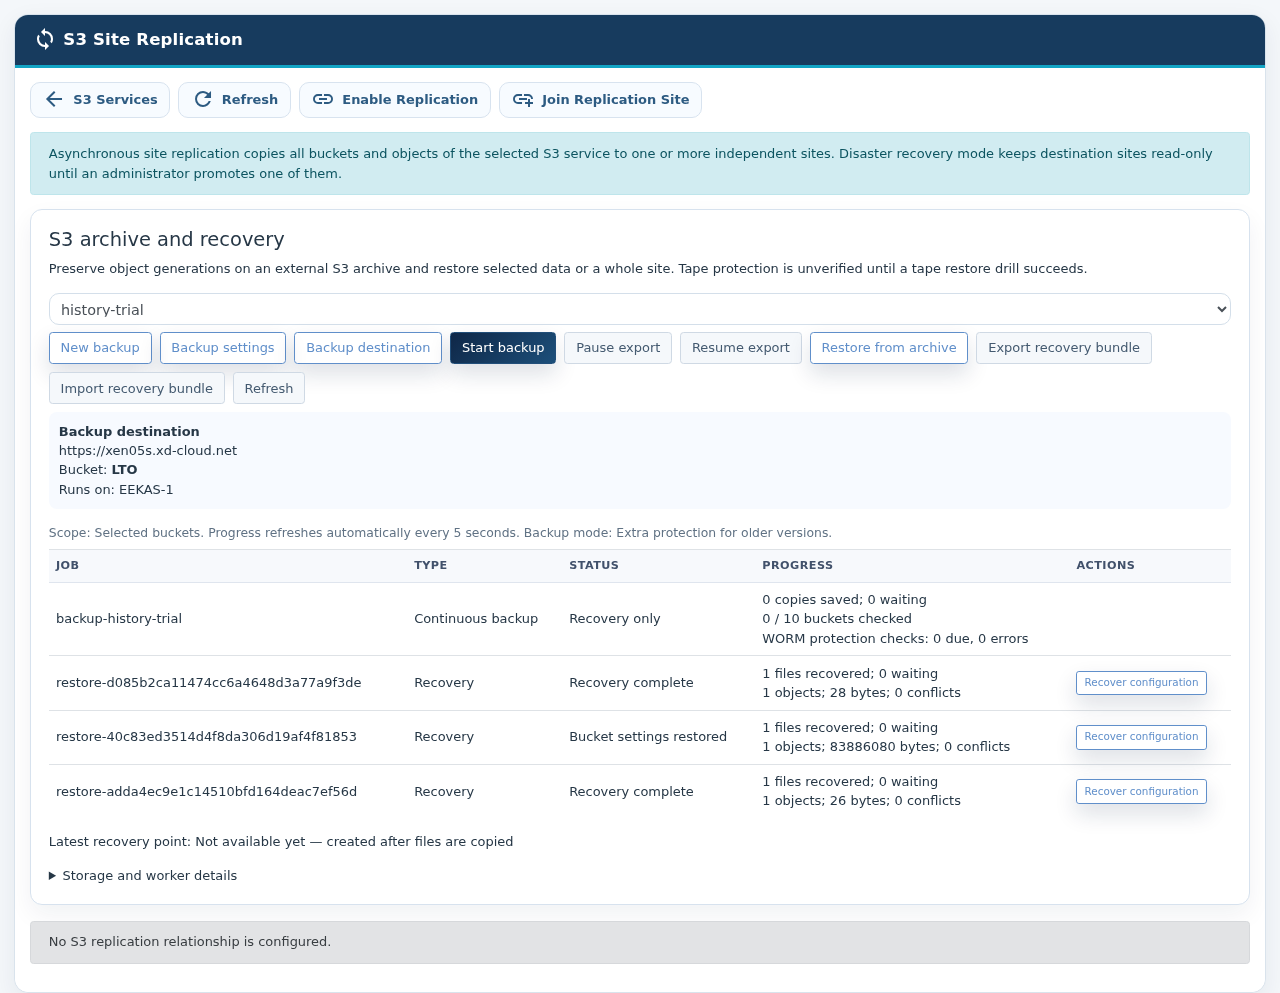
- Starten Sie den geprüften Job und überwachen Sie Fortschritt, Fehler sowie Pause/Resume oder Cancel.
- Verifizieren Sie Bytes, Aufbewahrung und Legal Holds. Prüfen Sie die Bucket-Konfigurationsvorschau vor Übernahme von Eigentümern und Berechtigungen. Ursprüngliche Eigentümer können dem Recovery-Konto den Zugriff entziehen; Lifecycle-Ablauf bleibt bei Konfigurationswiederherstellung deaktiviert.
- Stellen Sie Client-Routing und SMB-Gateway-/Freigabekonfiguration nach erfolgreicher Inhalts- und Berechtigungsprüfung wieder her.
Verwenden Sie neue Bucketnamen, statt WORM-Buckets zu löschen oder Aufbewahrung zu schwächen. Ältere Checkpoints ohne verifizierte Object-Lock-Metadaten werden abgewiesen. Unabhängig wiederhergestellte Objekte behalten nicht zwingend ihre ursprünglichen S3-Versionskennungen.
Nach Verlust der Primärinstallation
- Bereiten Sie eine funktionierende Ersatz-eEKAS-Installation mit S3-Dienst, Worker-Zugriff und Staging-Speicher vor.
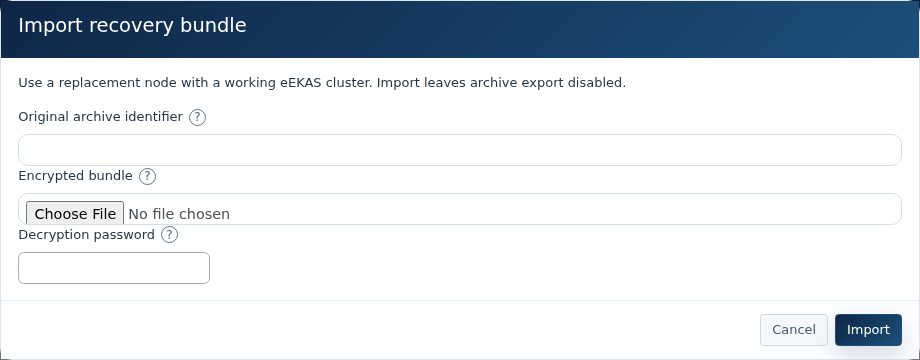
- Wählen Sie Import recovery bundle. Geben Sie ursprüngliche Archivkennung, verschlüsseltes Bundle kleiner als 16 MB und Kennwort an.
- Die importierte Konfiguration dient nur der Wiederherstellung; Export bleibt deaktiviert. Prüfen Sie Archivverbindung und lassen Sie Export während der Recovery ausgeschaltet.
- Erstellen Sie Vorschau und Restore, übernehmen Sie geprüfte Bucket-Einstellungen, validieren Sie Namensraum/Berechtigungen und schalten Sie Clients um.
Das Bundle ist kein eigenständiges Restore-Programm für beliebige Server. Langsame oder offline befindliche Medien können lange Abrufzeiten verursachen. Klären und testen Sie die physische Medienwiederherstellung beim Speicheranbieter separat.
9. Fehlerbehebung und Abnahme
| Symptom | Prüfung / Maßnahme |
|---|---|
| Kein leeres Ziel | Neuen S3-Dienst erstellen; keinen gefüllten Namensraum verbinden. |
| Einladung abgewiesen | Ablauf/Verwendung, REST API, Adresse/Port 18443, Routing und Zertifikatsvertrauen. |
| Behind, error oder unknown | Beide Standorte, Gateways, Endpunkte, Zertifikate, Kapazität, Zeitfenster und Verbindung. |
| Endpunkt weiterhin ausgefallen | Recover S3 gateways, IP-Gruppe/virtuellen Endpunkt und Fehlermeldung prüfen. |
| Worker-Heartbeat fehlt | Ausgewählten Knoten, Worker-Dienst, Quell-/Archivzugriff und Staging-Speicher prüfen. |
| Meldungsfehler / alter Checkpoint | Registrierung, Erreichbarkeit, Inventarisierungsverzug, Katalogfortschritt und Rückstand. Upload und Katalogveröffentlichung sind getrennt. |
| Leere Bucket-Suchseite | Bei Next page weiterblättern; begrenzte Suche kann nur einen Katalogteil untersuchen. |
| Restore-Konflikte | Neue Namen, Zielschutz, Berechtigungen, Object-Lock-Metadaten und fehlende Generationen prüfen. |
| SMB-Zugriff auf Restore fehlt | Gateway-Endpunkt, Bucket-/Pfadzuordnung, Zugangsdaten, Freigaben und Identitätskonfiguration prüfen. |
SMB-Daten gelangen erst nach erfolgreichem Commit eines S3-Objekts in die Sicherung. Offene/gepufferte Dateien, SMB-Freigabedefinitionen, Identitätsdienste und verteilte SMB-Sperren sind durch Objektreplikation allein nicht abgedeckt.
- Testen Sie eigene Testbuckets mit kleinen/großen Objekten, Multipart, Metadaten, Range Reads, Byteinhalt und Versionen.
- Prüfen Sie bei Active-Active beide Richtungen, Überschreiben, Löschen und Konflikte am selben Schlüssel bei aktiver Versionierung.
- Testen Sie Aufbewahrung/Legal Holds und Restore ohne Schwächung geschützter Quelldaten.
- Unterbrechen Sie die Verbindung, schreiben Sie kontrolliert, verbinden Sie erneut und prüfen Sie das Aufholen.
- Üben Sie Isolation, Promotion, Client-Routing und Failback isoliert. Testen Sie lokale Gateway-Recovery separat.
- Exportieren/importieren Sie ein Bundle, stellen Sie einen abgeschlossenen Checkpoint in neue Buckets wieder her und prüfen Sie Eigentümer sowie SMB-Nutzerzugriff.
- Messen Sie Backfill, vollständige Katalogdauer, Worker-Speicher, Rückstand und Restore-Dauer anhand repräsentativer Objektanzahl und Größen.
Die Evaluation umfasste eine Basis mit 1.000 Objekten und ausgewählte native Replikations-, WORM- und Unterbrechungstests. Millionenobjektkapazität, vollständige Cluster-Recovery/Failback, der komplette SMB-Ablauf und neue externe Mirror-Abnahme stehen noch aus. Legen Sie RPO/RTO anhand gemessener Installationsergebnisse fest.
Täglich: jeden nativen Standort, Export-Heartbeat, letzten vollständigen Checkpoint, Fehler und Alarmzustellung prüfen. Nach Änderungen: Umfang, künftige Buckets, Schlüssel, Vertrauen, Routing und Bundle-Aktualität prüfen. Regelmäßig: Lesen, Schutz und Recovery testen, Kapazität prüfen. Vor Stilllegung: verifizierte Wiederherstellungsalternative behalten.