
Dashboard, Health und Cluster-Status
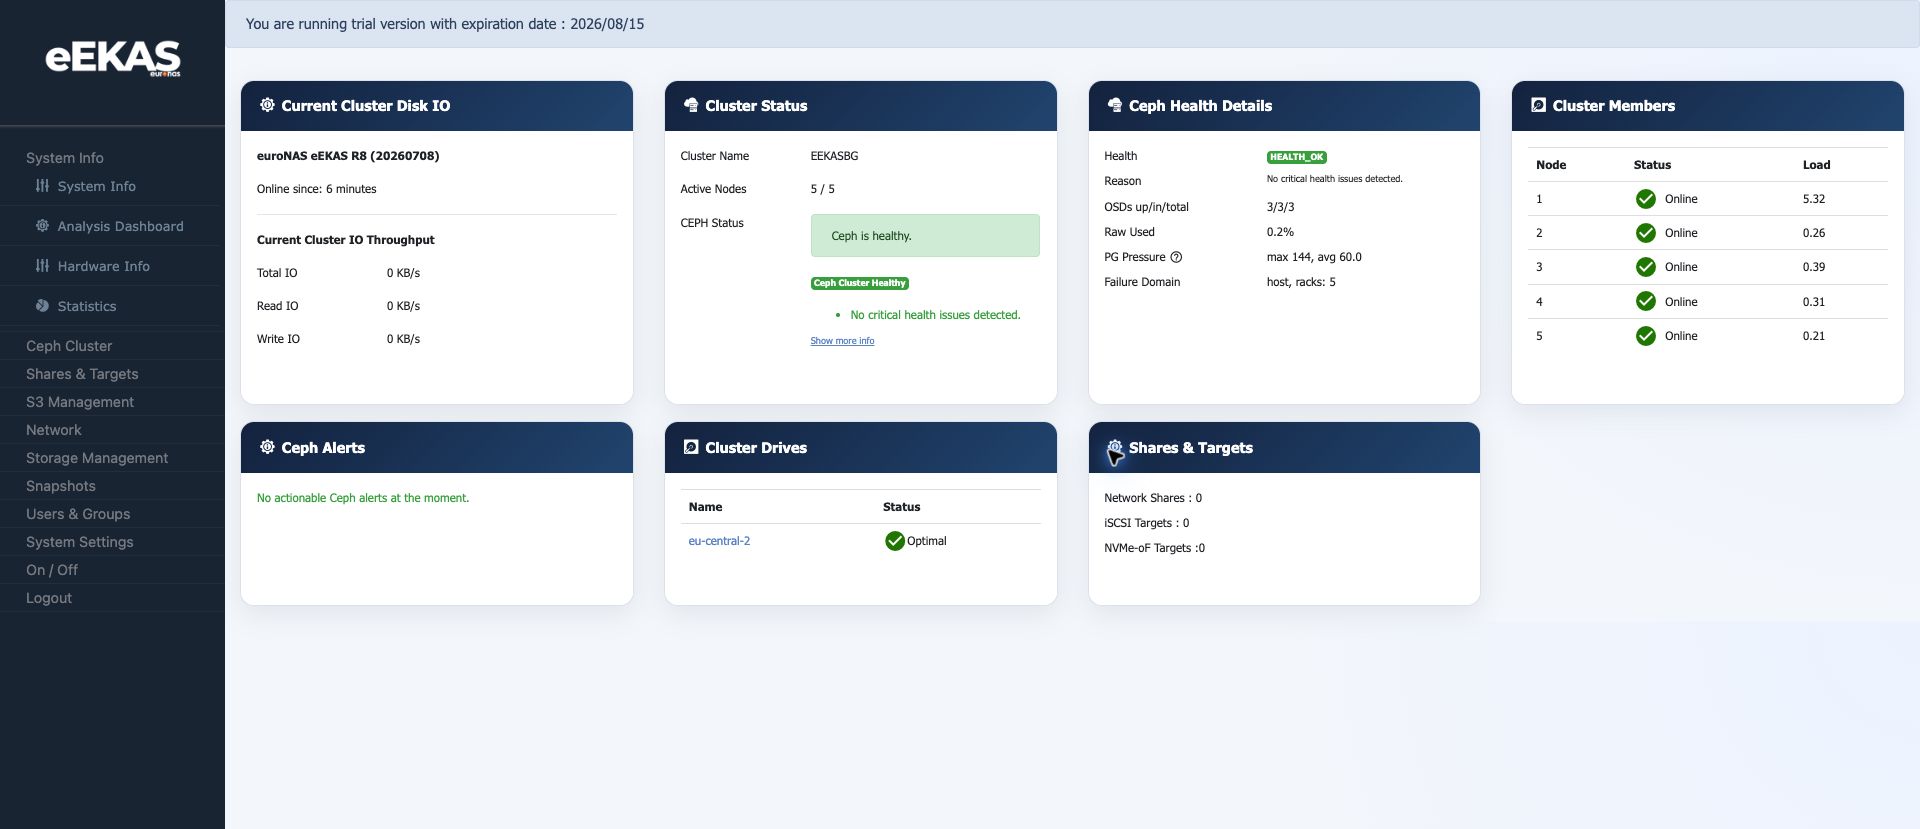
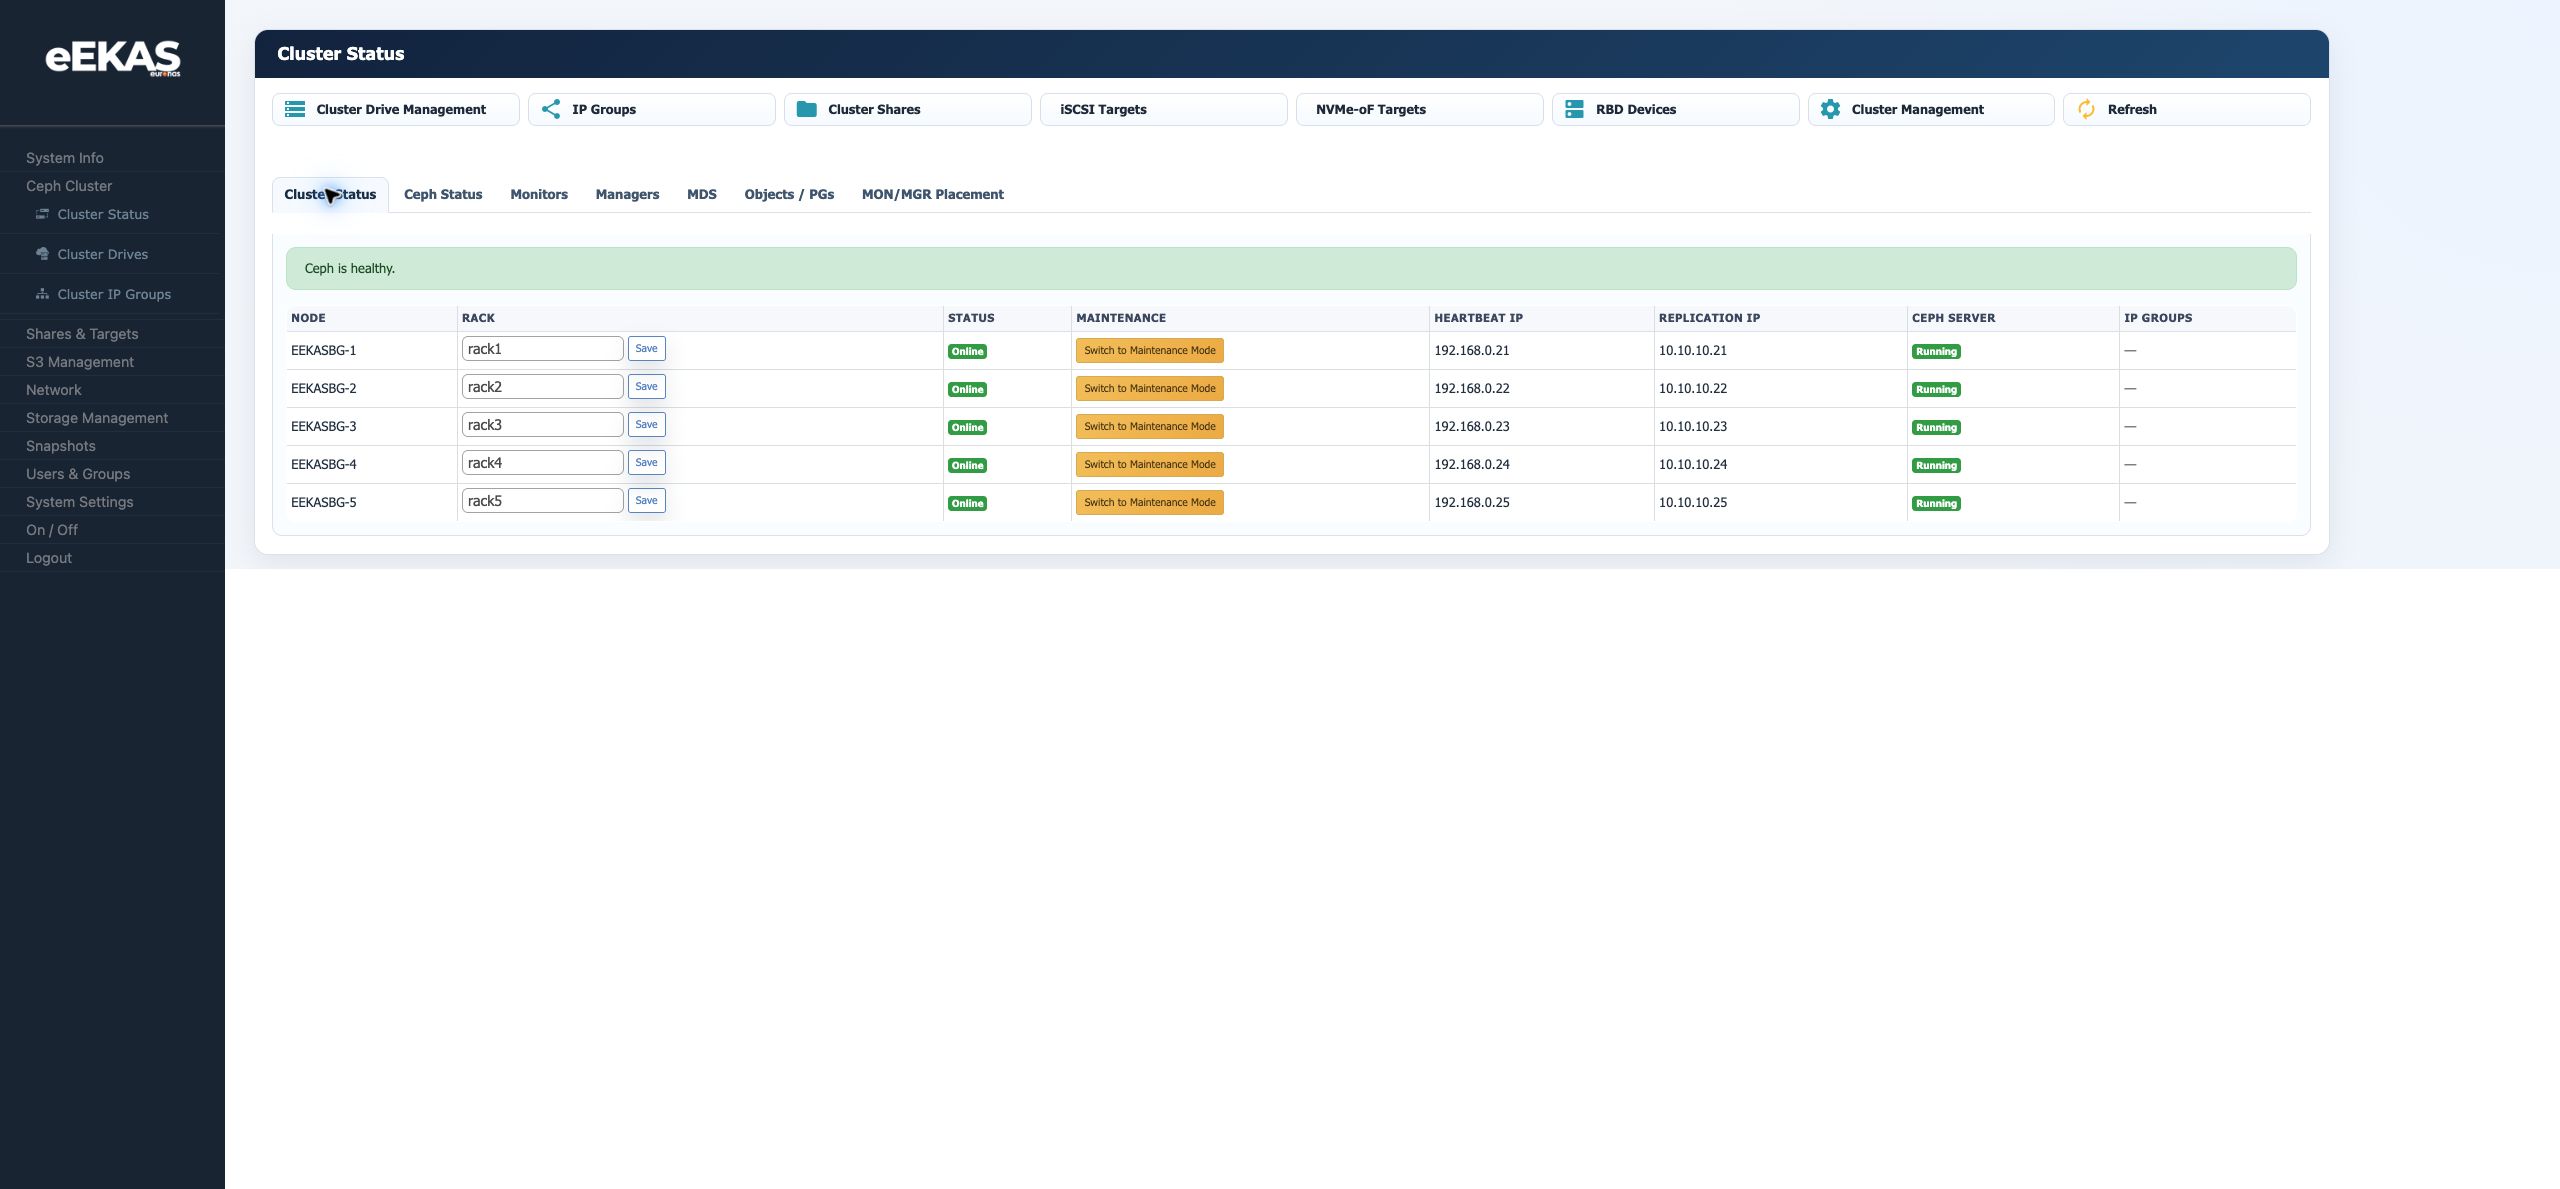
Das eEKAS Dashboard istund die ersteAnsicht BetriebsansichtCluster Status sind die ersten Betriebsansichten nach der Anmeldung. EsZusammen zeigtzeigen sie Laufzeit, Cluster Health, Node-Verfügbarkeit, Ceph Status, Cluster-Laufwerke und Service-Zähler an einer zentralen Stelle.Zähler.
Was dasdie DashboardCluster-Status-Ansicht zeigt
| Bereich | Bedeutung |
|---|---|
| Management- bzw. Heartbeat-Netzwerk zur Überwachung der Node-Verfügbarkeit. | |
| Replication IP | Cluster- |
| Ceph |
|
Gesunder NormalzustandZustand im Testcluster
Der Testcluster zeigte fünf Nodes online: EEKASBG-1 bis EEKASBG-5. Jeder Node meldete Ceph Server als Running. Die Heartbeat-Adressen verwendeten das Netzwerk 192.168.0.x, die Replication-Adressen das Netzwerk 10.10.10.x.
Ein gesunder ClusterBetriebszustand sollte normalerweise alle erwarteten Nodes online zeigen,online, Ceph alshealthy, healthyCeph beziehungsweiseServer HEALTH_OKauf melden, alleallen erwarteten OSDsNodes uprunning und inkeinen haben,unerwarteten keineMaintenance aktionsrelevanten Ceph Alerts anzeigen und Cluster Drives im optimalen ZustandMode zeigen.
Im Testsystem zeigte das Dashboard 5 aktive Nodes von 5 und Ceph meldete HEALTH_OK. Dies ist der Zustand, der vor der Bereitstellung von Shares, Targets oder S3-Diensten erwartet werden sollte.
Tägliche Betriebsprüfung
- Prüfen, ob alle erwarteten Nodes online sind.
- Prüfen, ob Ceph healthy ist.
OSDsPrüfen,up/in/totalobkontrollieren.Ceph Server auf jedem erwarteten Node Running meldet.PG PressureHeartbeat- undRawReplication-IPUsedauf Konsistenz prüfen.CephPrüfen,AlertsobaufeinaktionsrelevanteNodeMeldungenimprüfen.Maintenance Mode ist.ClusterBeiDrivesWarnungenaufmitoptimalenCephZustandStatusprüfen.Service-Zähler für Shares und Targets prüfen.fortfahren.
Wann genauer geprüft werden sollte
Eine genauere Prüfung ist sinnvoll, wenn Nodesein Node offline sind,ist, ein Ceph Server nicht läuft, ein Node unerwartet im Maintenance Mode ist, Heartbeat- oder Replication-IP nicht stimmen oder Ceph nicht healthy ist, OSDs nicht up/in sind, PG Pressure unerwartet hoch ist, Alerts angezeigt werden oder ein Cluster Drive nicht optimal ist.
Dokumentationshinweis
Dashboard-Werte sind Momentaufnahmen. Für Supportfälle sollten Dashboard-Screenshot, Uhrzeit, betroffener Dienst und eine kurze Fehlerbeschreibung festgehalten werden.