
Dashboard, Health und Cluster-Status
Das eEKAS Dashboard ist die erste Betriebsansicht nach der Anmeldung. Es zeigt Laufzeit, Cluster Health, Node-Verfügbarkeit, Ceph Status, Cluster-Laufwerke und Service-Zähler an einer zentralen Stelle.
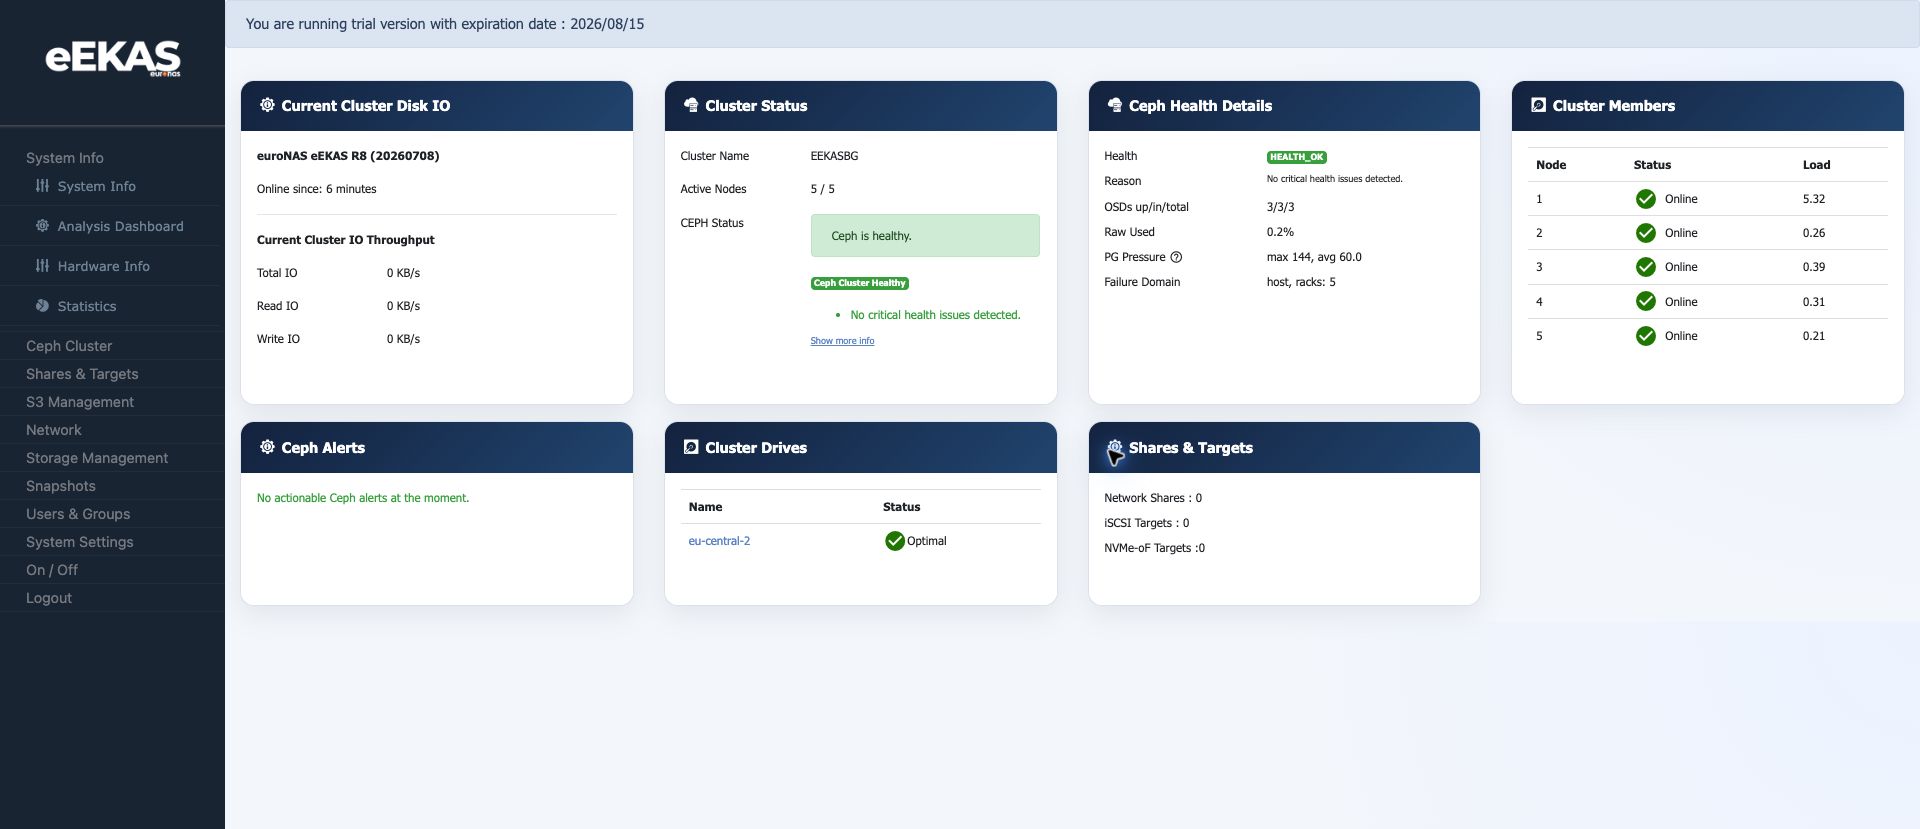
Was das Dashboard zeigt
| Bereich | Bedeutung |
|---|---|
| Software-Version | Installierte eEKAS Version und Build. Im Testcluster war dies eEKAS R8 (20260708). |
| Online seit | Laufzeit der aktuellen Node- oder Appliance-Sitzung. |
| Current Cluster IO | Aktueller Lese-, Schreib- und Gesamt-Durchsatz des Clusters. |
| Cluster Status | Cluster-Name, aktive Nodes und allgemeiner Ceph-Zustand. |
| Ceph Health Details | Health, Grund, OSD-Anzahl, Raw Used, PG Pressure und Failure Domain. |
| Cluster Members | Liste der Nodes mit Online-Status und aktueller Last. |
| Ceph Alerts | Aktionsrelevante Health-Warnungen, falls vorhanden. |
| Cluster Drives | Gesamtstatus der konfigurierten Cluster Drives. |
| Shares & Targets | Anzahl von Netzwerkfreigaben, iSCSI Targets und NVMe-oF Targets. |
Gesunder Normalzustand
Ein gesunder Cluster sollte alle erwarteten Nodes online zeigen, Ceph als healthy beziehungsweise HEALTH_OK melden, alle erwarteten OSDs up und in haben, keine aktionsrelevanten Ceph Alerts anzeigen und Cluster Drives im optimalen Zustand zeigen.
Im Testsystem zeigte das Dashboard 5 aktive Nodes von 5 und Ceph meldete HEALTH_OK. Dies ist der Zustand, der vor der Bereitstellung von Shares, Targets oder S3-Diensten erwartet werden sollte.
Tägliche Betriebsprüfung
- Prüfen, ob alle erwarteten Nodes online sind.
- Prüfen, ob Ceph healthy ist.
- OSDs up/in/total kontrollieren.
- PG Pressure und Raw Used prüfen.
- Ceph Alerts auf aktionsrelevante Meldungen prüfen.
- Cluster Drives auf optimalen Zustand prüfen.
- Service-Zähler für Shares und Targets prüfen.
Wann genauer geprüft werden sollte
Eine genauere Prüfung ist sinnvoll, wenn Nodes offline sind, Ceph nicht healthy ist, OSDs nicht up/in sind, PG Pressure unerwartet hoch ist, Alerts angezeigt werden oder ein Cluster Drive nicht optimal ist.
Dokumentationshinweis
Dashboard-Werte sind Momentaufnahmen. Für Supportfälle sollten Dashboard-Screenshot, Uhrzeit, betroffener Dienst und eine kurze Fehlerbeschreibung festgehalten werden.