
S3 Site Replication
Die Screenshots zeigen die englische Benutzeroberfläche. Angezeigte Namen und Adressen sind Beispiele; verwenden Sie die für Ihre Umgebung festgelegten Werte.
Zweck und Zielgruppe
Dieses Handbuch richtet sich an System- und Speicheradministratoren, die eine asynchrone S3-Replikation zwischen unabhängigen eEKAS-Clustern konfigurieren. Alle Abläufe verwenden die grafische euroNAS-Oberfläche; ein Kommandozeilenzugriff ist nicht erforderlich.
Begriffe
| Begriff | Bedeutung |
|---|---|
| Primärstandort | Aktuell maßgeblicher Schreibstandort. |
| Sekundärstandort | Entfernter Standort, der asynchrone Änderungen empfängt. |
| S3-Dienst | Konfigurierter Objektspeicherdienst mit Endpunkt und Ceph-Speicher. |
| IP-Gruppe | Dienstadressen und geordnete geeignete Gateway-Knoten eines Clusters. |
| Disaster-Recovery-Modus | Sekundärstandort bleibt bis zur kontrollierten Heraufstufung schreibgeschützt. |
| Active-Active-Modus | Schreiben an mehreren Standorten; nur für geeignete Anwendungen. |
| Einladung | Kurzlebiges Vertrauenspaket zum einmaligen Verbinden eines Zielstandorts. |
Voraussetzungen
- Zwei fehlerfreie, unabhängige eEKAS-Cluster.
- Ein konfigurierter und erreichbarer S3-Dienst am Primärstandort.
- Ein konfigurierter, aber leerer S3-Dienst am Zielstandort.
- Ausreichende Zielkapazität und eine geeignete Ceph-Schutzrichtlinie.
- Stabile DNS-Namen für beide S3-Endpunkte.
- HTTPS-Managementverbindung vom Ziel zum Primärstandort auf Port 18443 oder ein sicherer Weg zur Übertragung einer verschlüsselten Einladungsdatei.
- S3-Endpunktverbindung zwischen den Standorten.
- Synchronisierte Zeit, gültige Zertifikate und funktionierende Namensauflösung auf jedem Gateway-Knoten.
- Dokumentierte RPO-, RTO-, Freigabe- und Client-Umleitungsprozesse.
Planungsblatt
| Element | Primärstandort | Zielstandort |
|---|---|---|
| Standortname | primary-site-01 | secondary-site-01 |
| S3-Dienst | eu-west-1 | leerer Zieldienst |
| S3-DNS-Name | s3.primary.example | s3.secondary.example |
| S3-Port | 443 oder konfigurierter Port | 443 oder konfigurierter Port |
| Managementadresse | HTTPS-Adresse, Port 18443 | Für Einlösung nicht erforderlich |
| IP-Gruppe | Name und Gateway-Reihenfolge | Name und Gateway-Reihenfolge |
| Modus | Maßgeblicher Schreibstandort | Standardmäßig Disaster Recovery |
1. IP-Gruppe an jedem Standort konfigurieren
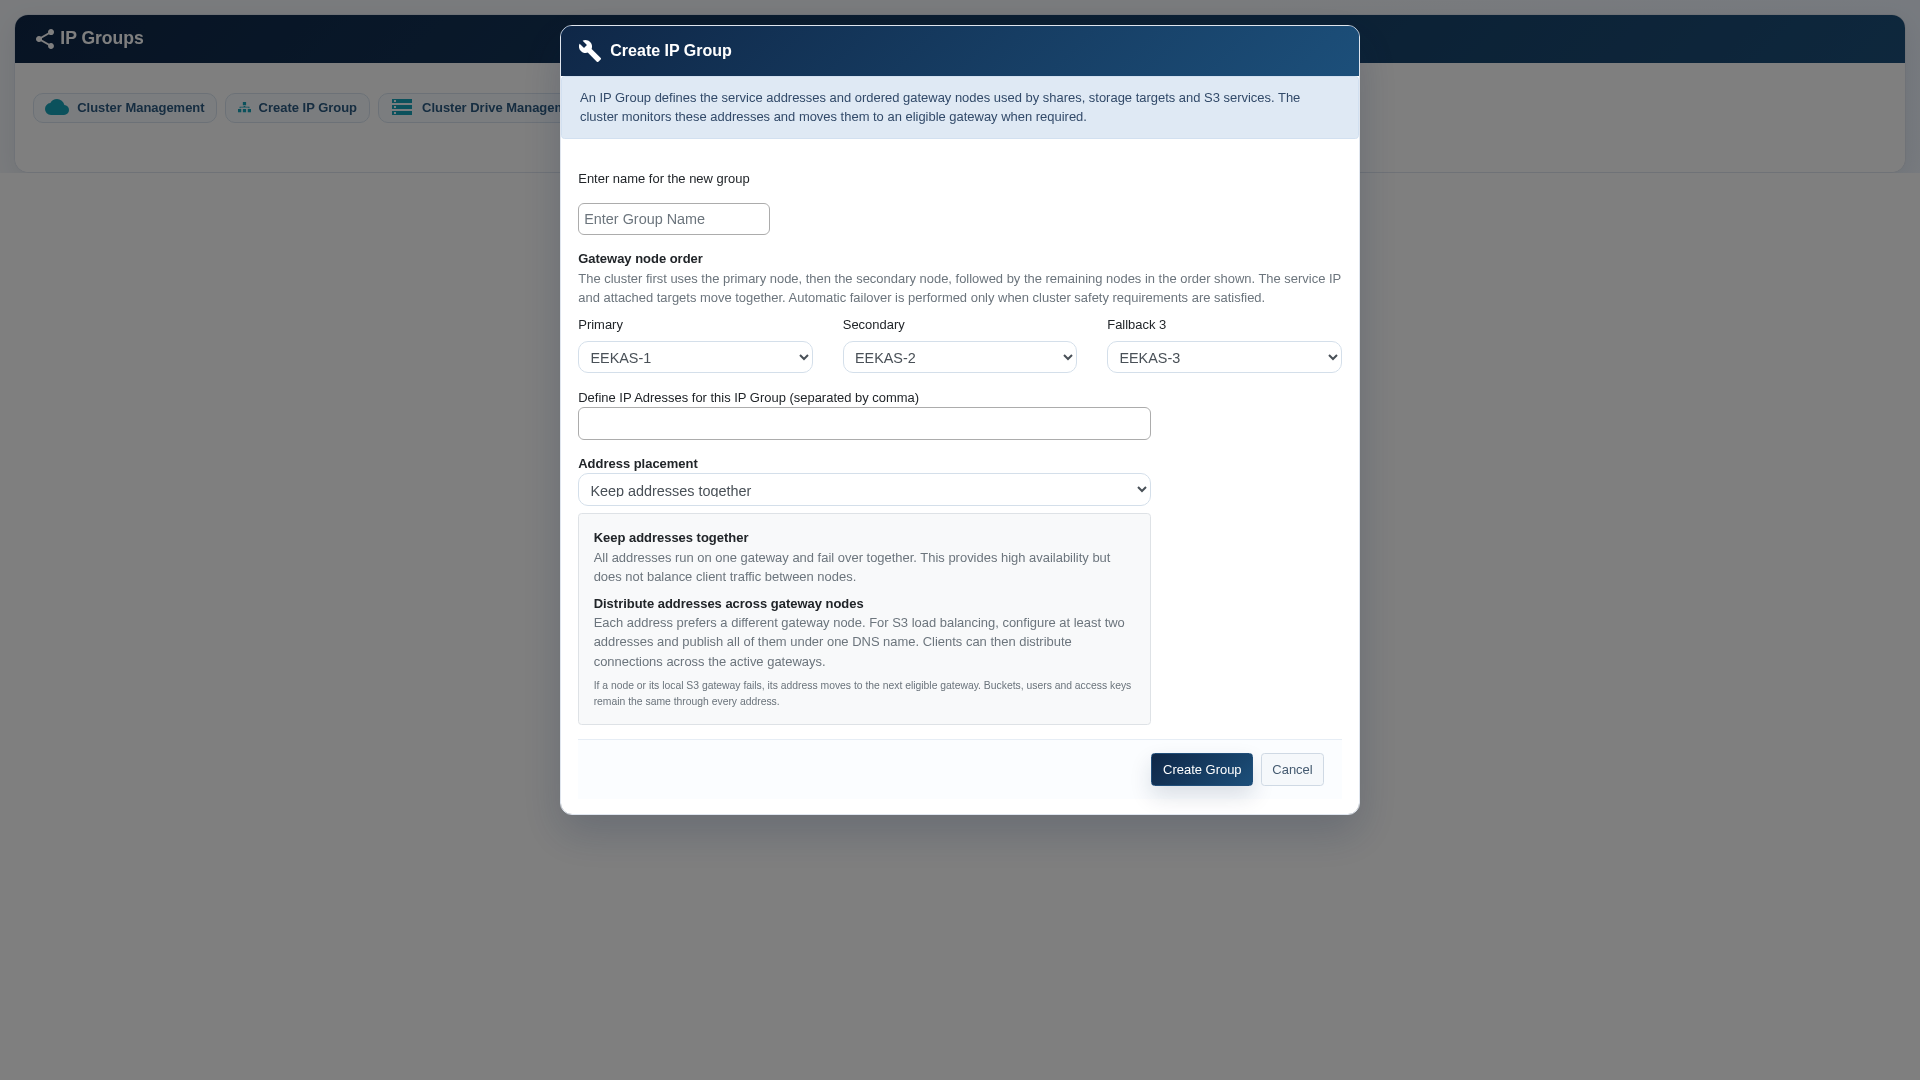
Öffnen Sie Cluster Management und wählen Sie Create IP Group. Definieren Sie einen neutralen Namen, die geordneten Gateway-Knoten und eine oder mehrere Dienstadressen. Bei einer Adresse ist jeweils ein Gateway aktiv. Mehrere verteilte Adressen können Client-Verbindungen aufteilen, wenn alle unter einem DNS-Namen veröffentlicht werden.
- Setzen Sie das bevorzugte Gateway an die erste Stelle und definieren Sie Sekundär- und Fallback-Knoten.
- Wählen Sie Keep addresses together für eine einfache aktive/passive Dienstadresse.
- Verwenden Sie Distribute addresses across gateway nodes nur mit mindestens zwei Adressen und passender DNS-Verteilung.
- Prüfen Sie die Erreichbarkeit des Adressnetzes durch S3-Clients.
2. S3-Dienste erstellen
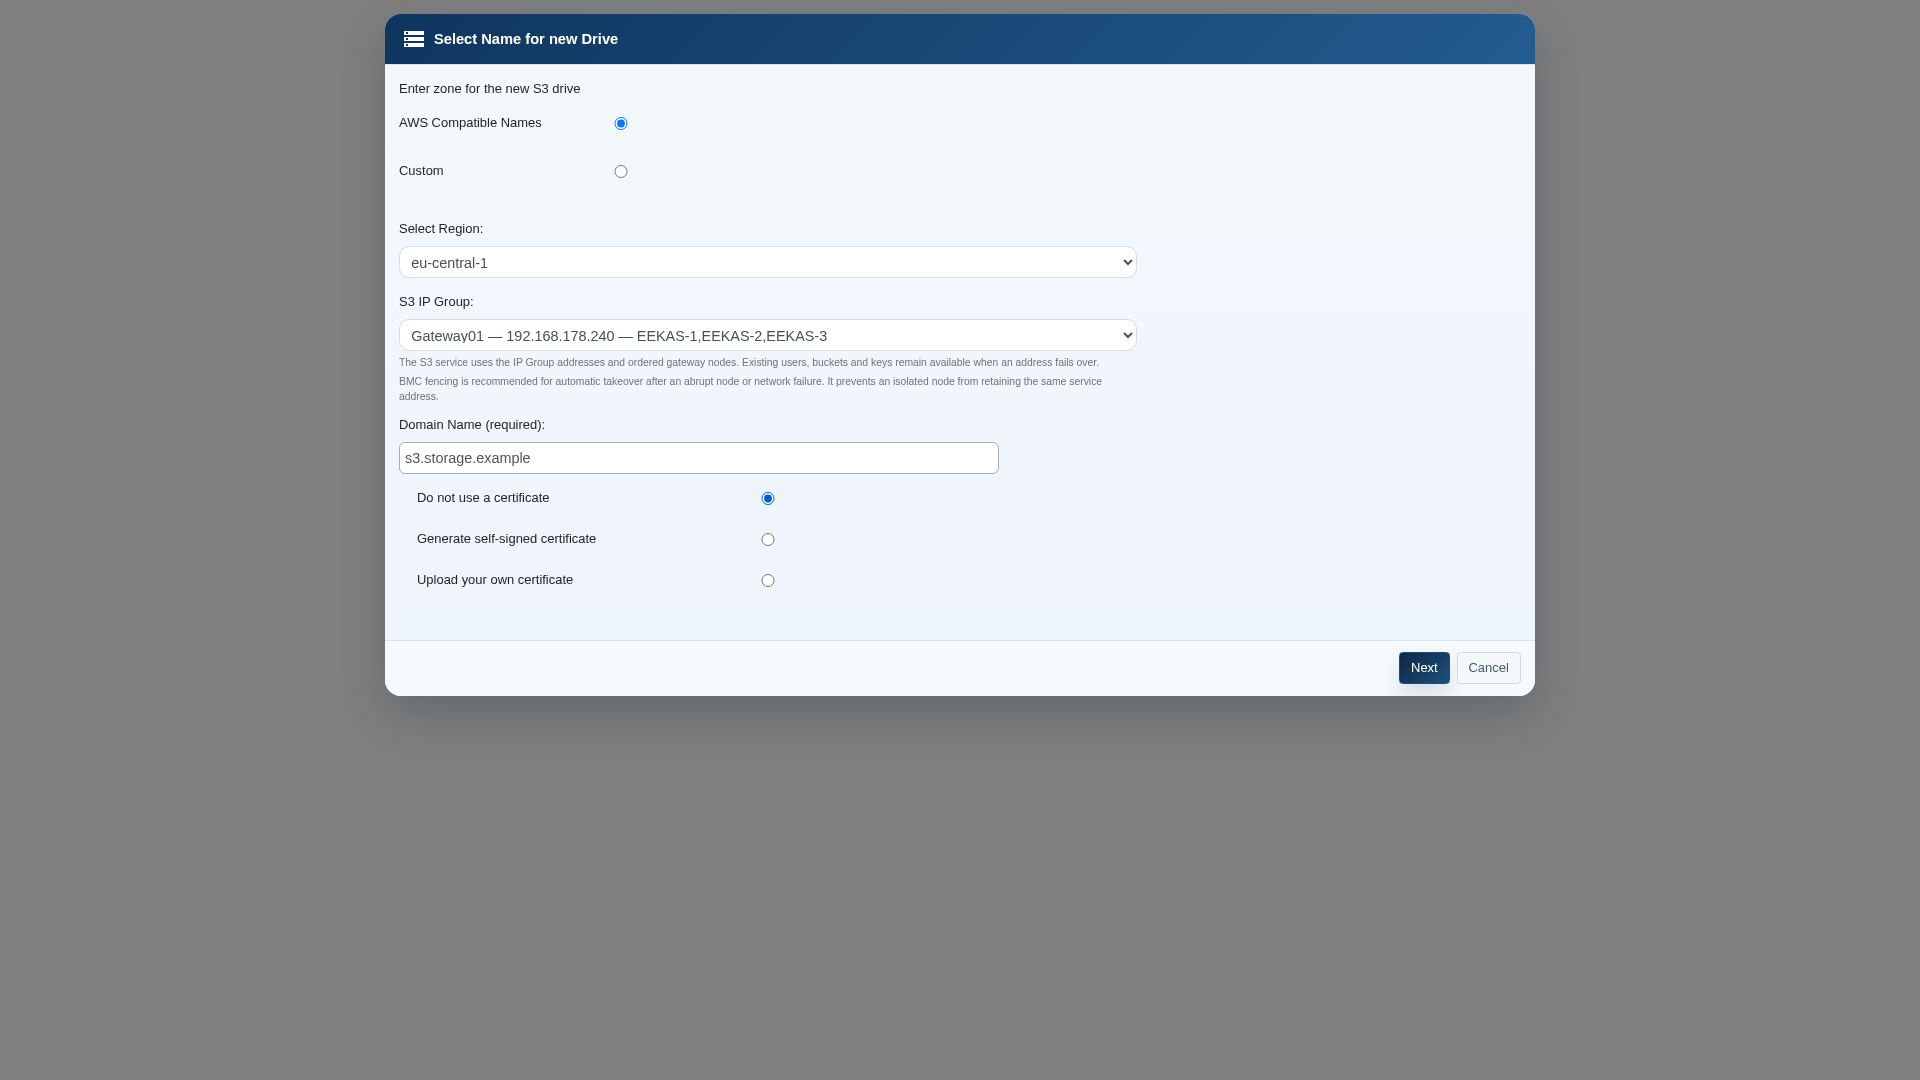
Erstellen Sie den primären S3-Speicherdienst und weisen Sie IP-Gruppe, DNS-Namen, Zertifikat und lokalen Speicher zu. Erstellen Sie am Ziel einen separaten S3-Dienst mit eigener IP-Gruppe und eigenem Speicher, jedoch ohne Buckets oder Objekte. Nur ein leerer Zieldienst kann übernommen werden.
3. Replikation am Primärstandort aktivieren
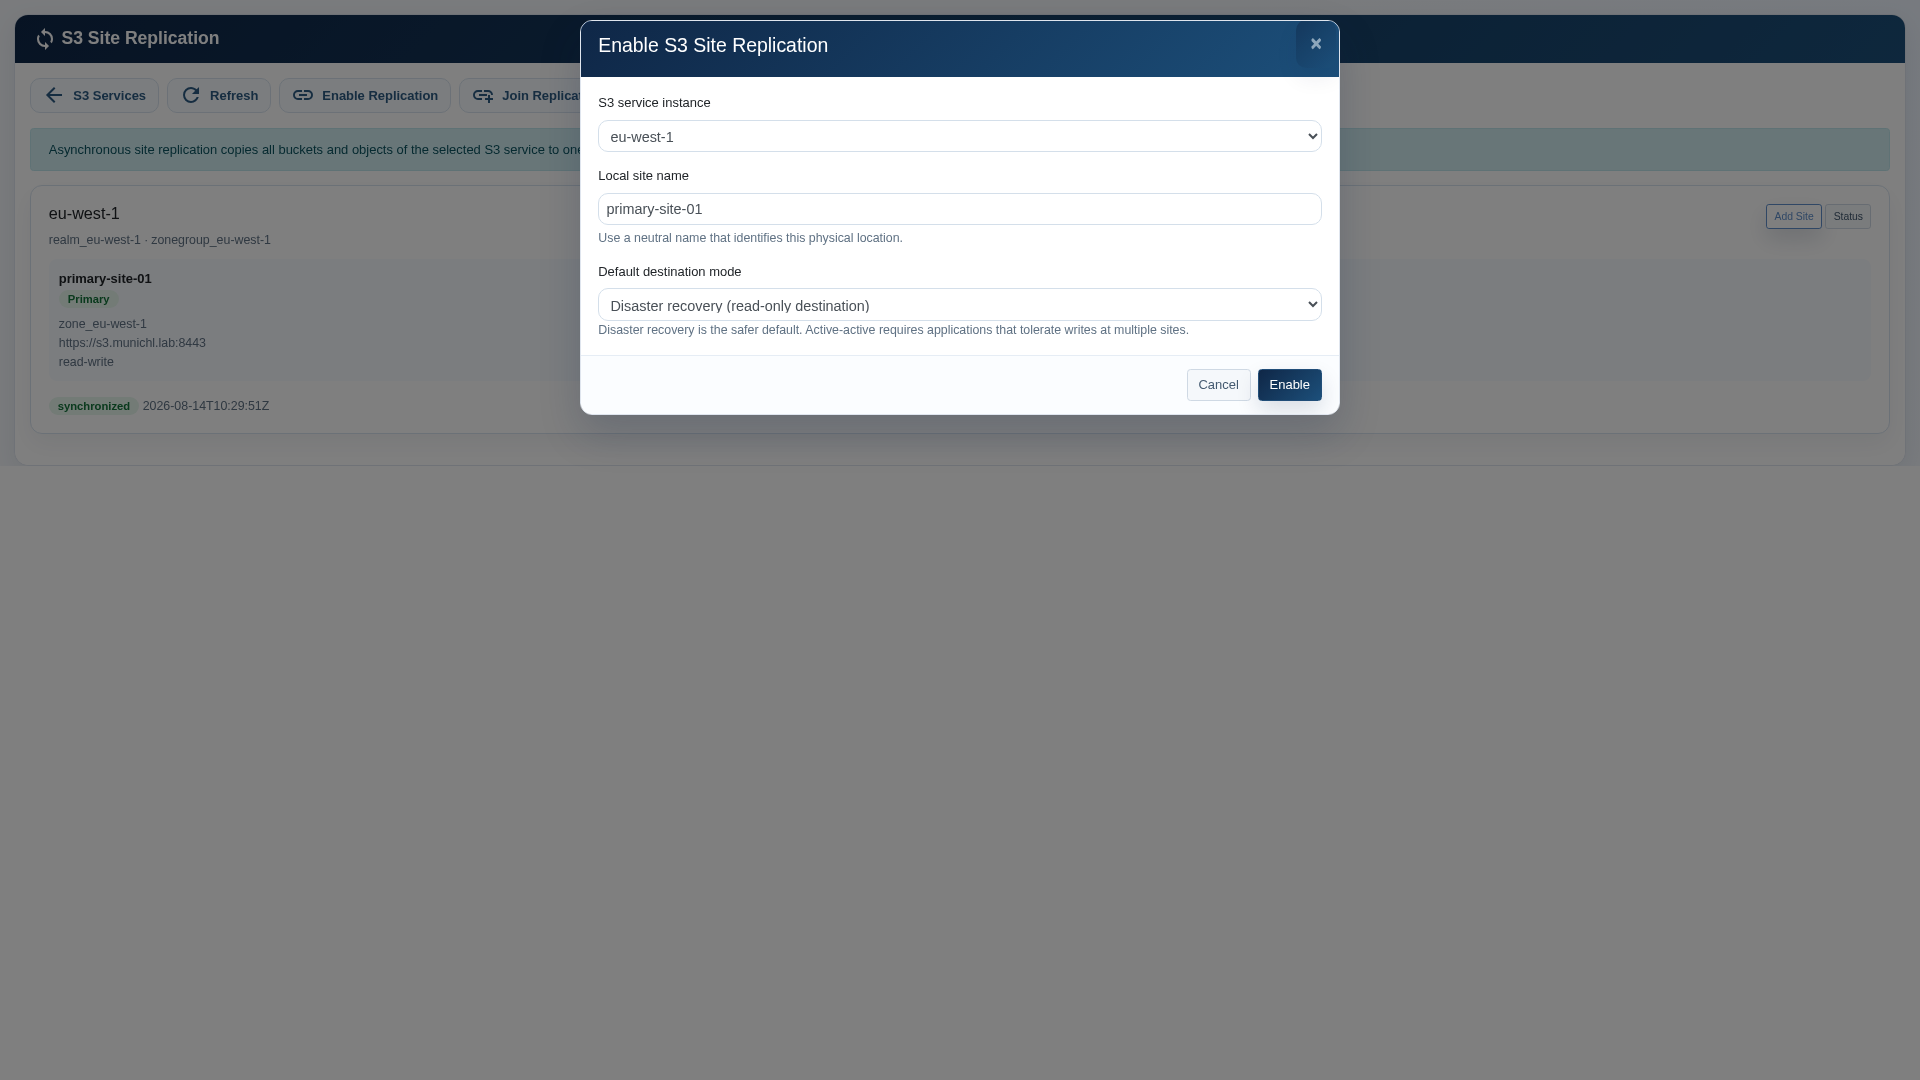
Öffnen Sie S3 Console, wählen Sie Site Replication und anschließend Enable Replication.
- Wählen Sie den zu schützenden S3-Dienst.
- Geben Sie einen neutralen Standortnamen ein, beispielsweise primary-site-01.
- Wählen Sie Disaster recovery, sofern die Anwendung nicht ausdrücklich für gleichzeitige standortübergreifende Schreibzugriffe validiert wurde.
- Wählen Sie Enable und warten Sie, bis die Beziehung angezeigt wird.
4. Einladung für den Zielstandort erstellen
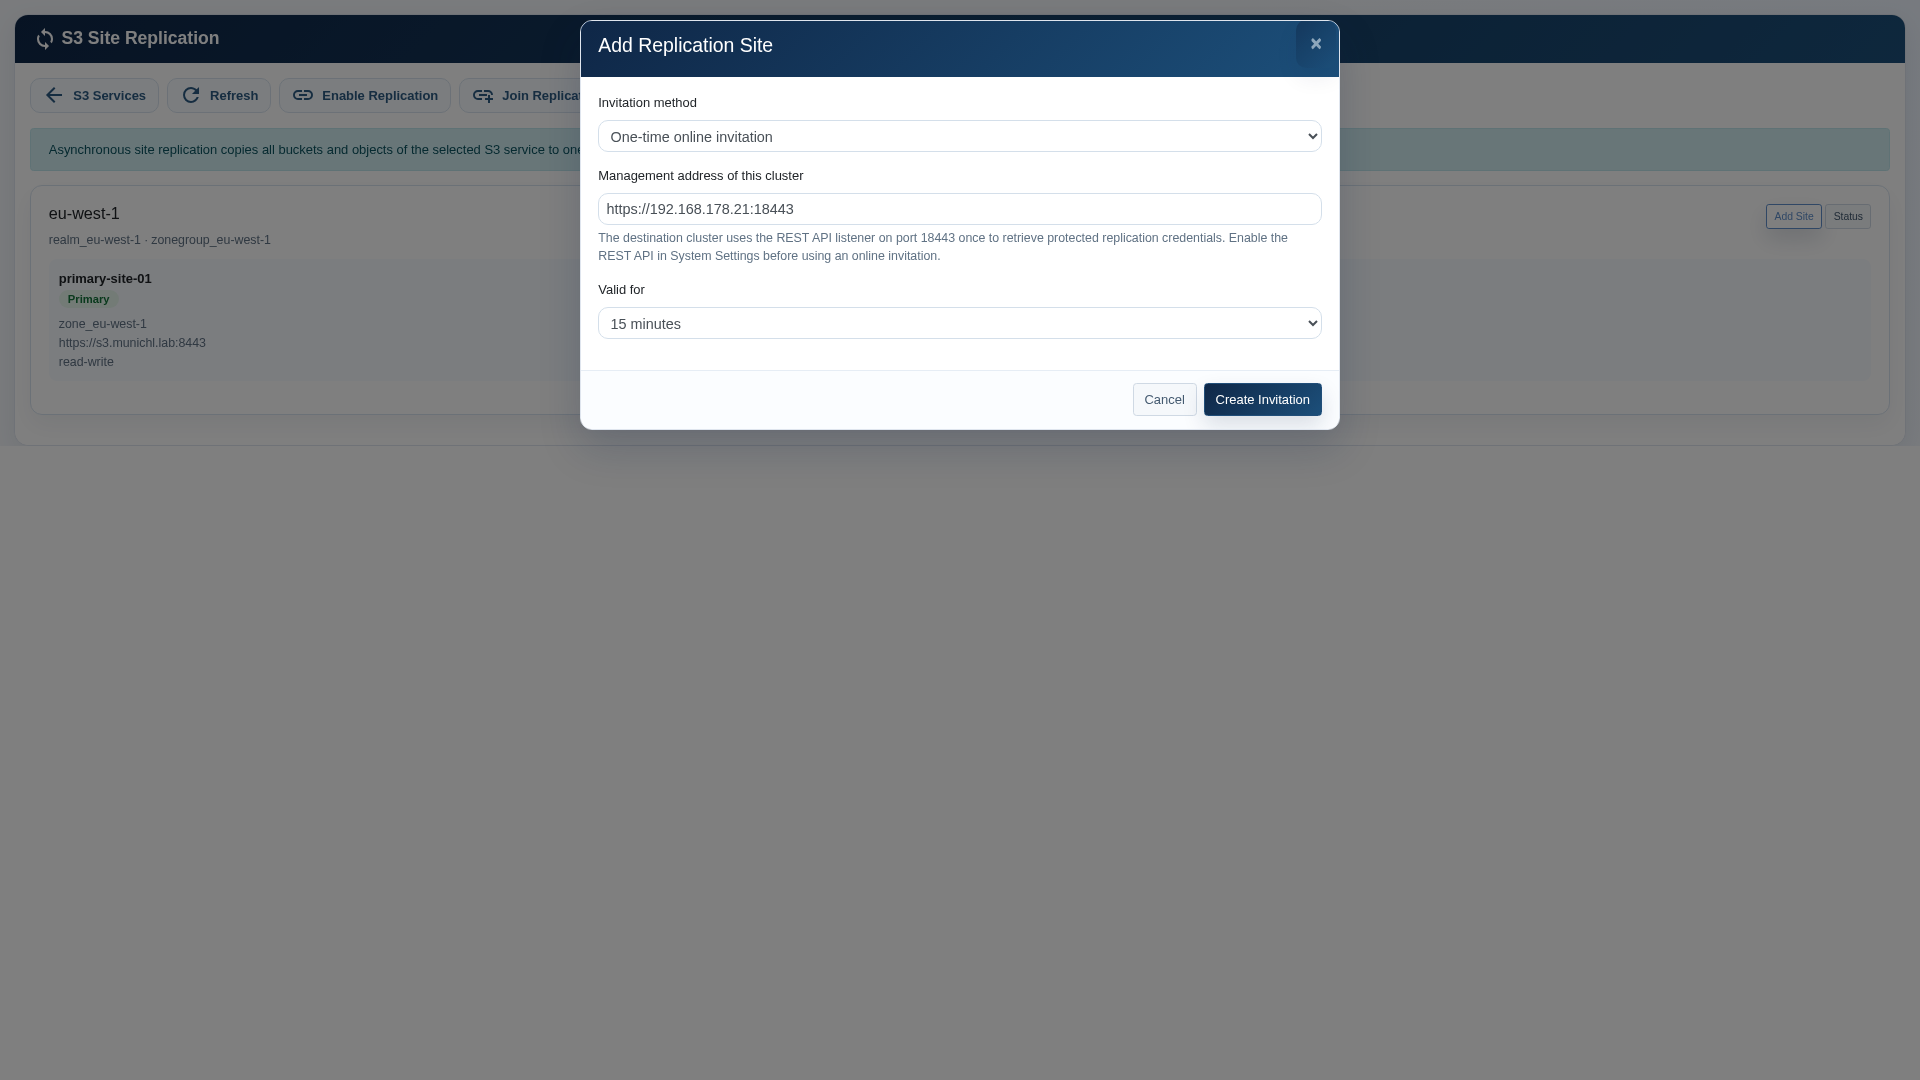
Wählen Sie in der primären Beziehung Add Site. Für normal verbundene Installationen verwenden Sie One-time online invitation.
- Bestätigen Sie die Managementadresse des Primärstandorts und HTTPS-Port 18443.
- Wählen Sie die kürzeste praktikable Gültigkeitsdauer.
- Wählen Sie Create Invitation und übertragen Sie Token und Managementadresse sicher.
- Wenn keine Managementverbindung möglich ist, verwenden Sie die verschlüsselte Einladungsdatei und übertragen Datei und Kennwort über getrennte sichere Kanäle.
5. Zielstandort verbinden
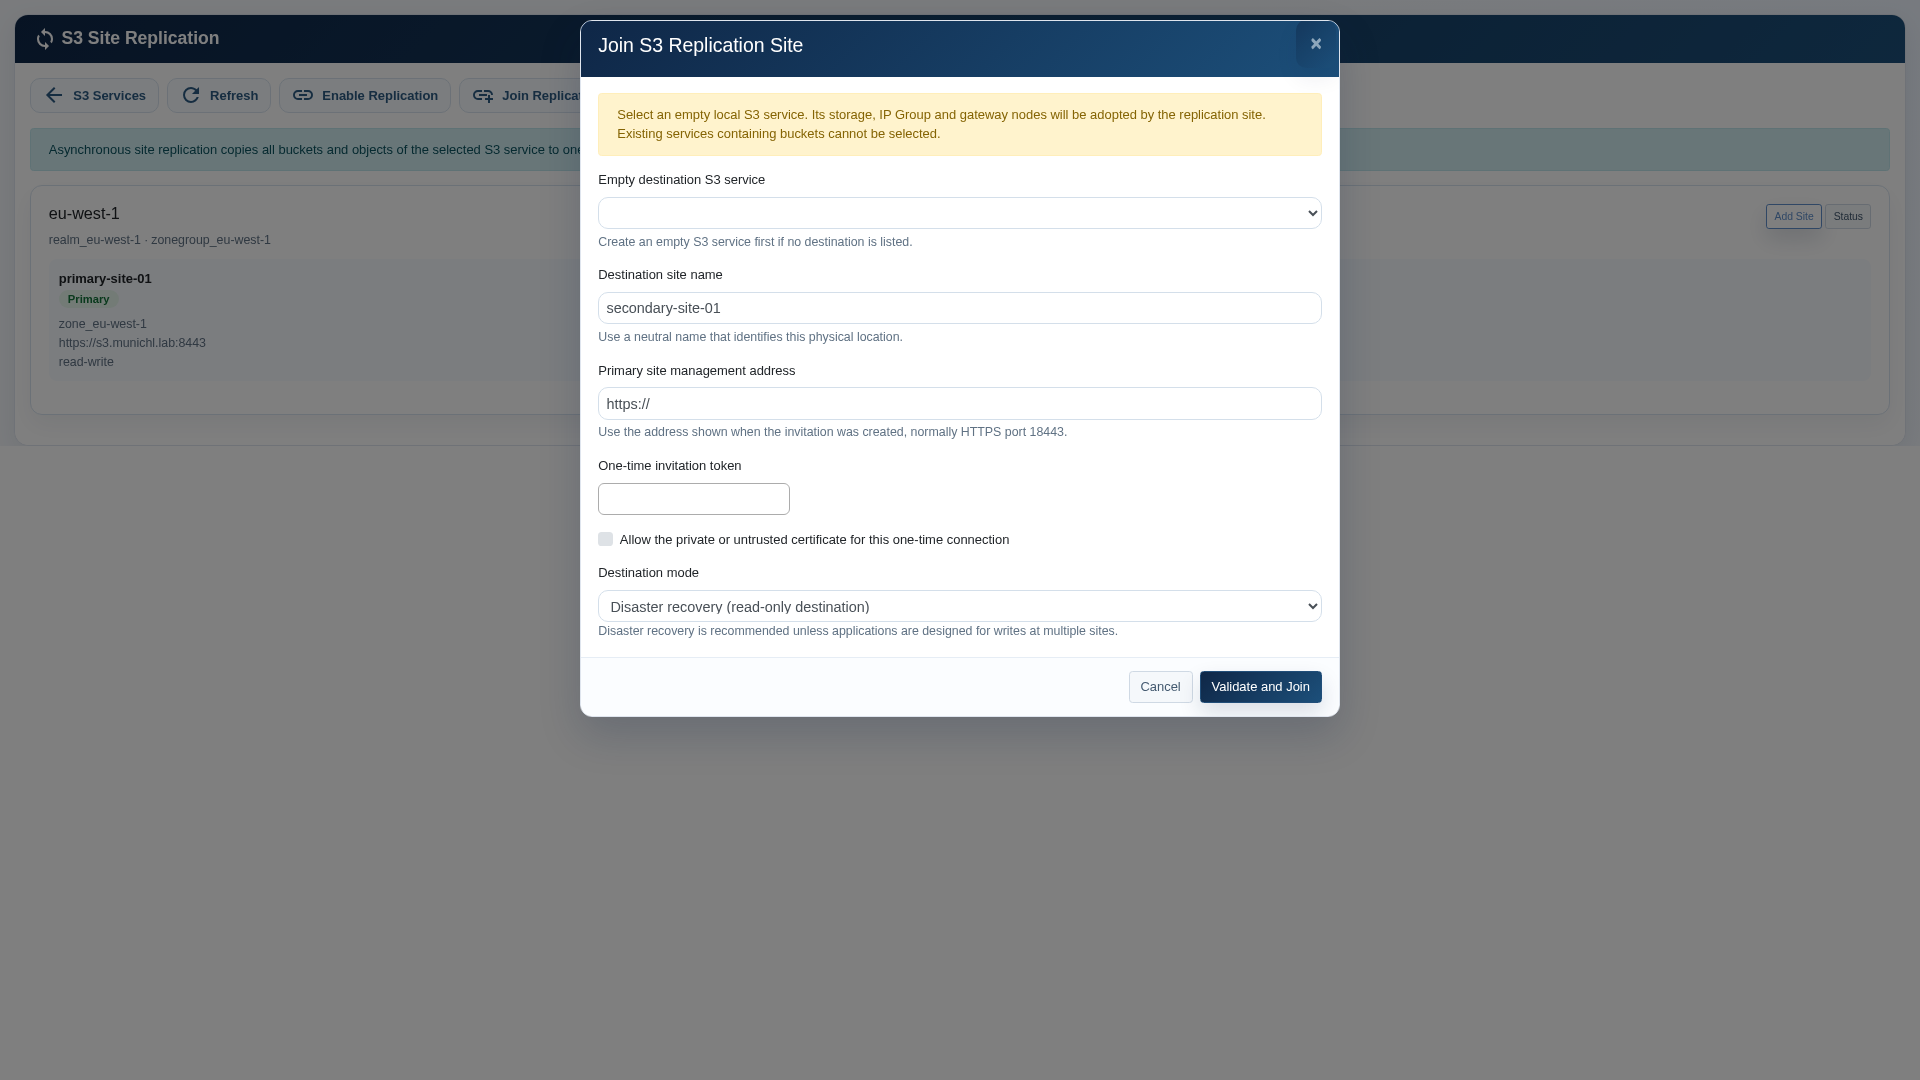
Melden Sie sich am Zielcluster an, öffnen Sie S3 Console und Site Replication und wählen Sie Join Replication Site.
- Wählen Sie den leeren S3-Zieldienst. Speicher, IP-Gruppe, Listener-Port und Gateway-Auswahl werden übernommen.
- Geben Sie einen neutralen Zielstandortnamen ein.
- Geben Sie Managementadresse und einmaliges Einladungstoken ein.
- Aktivieren Sie die Annahme eines privaten Zertifikats nur in einer kontrollierten Umgebung nach unabhängiger Prüfung.
- Behalten Sie Disaster recovery bei, sofern Active-Active nicht freigegeben wurde.
- Wählen Sie Validate and Join und schließen Sie die Seite während der Gateway-Bereitstellung nicht.
6. Synchronisierung prüfen
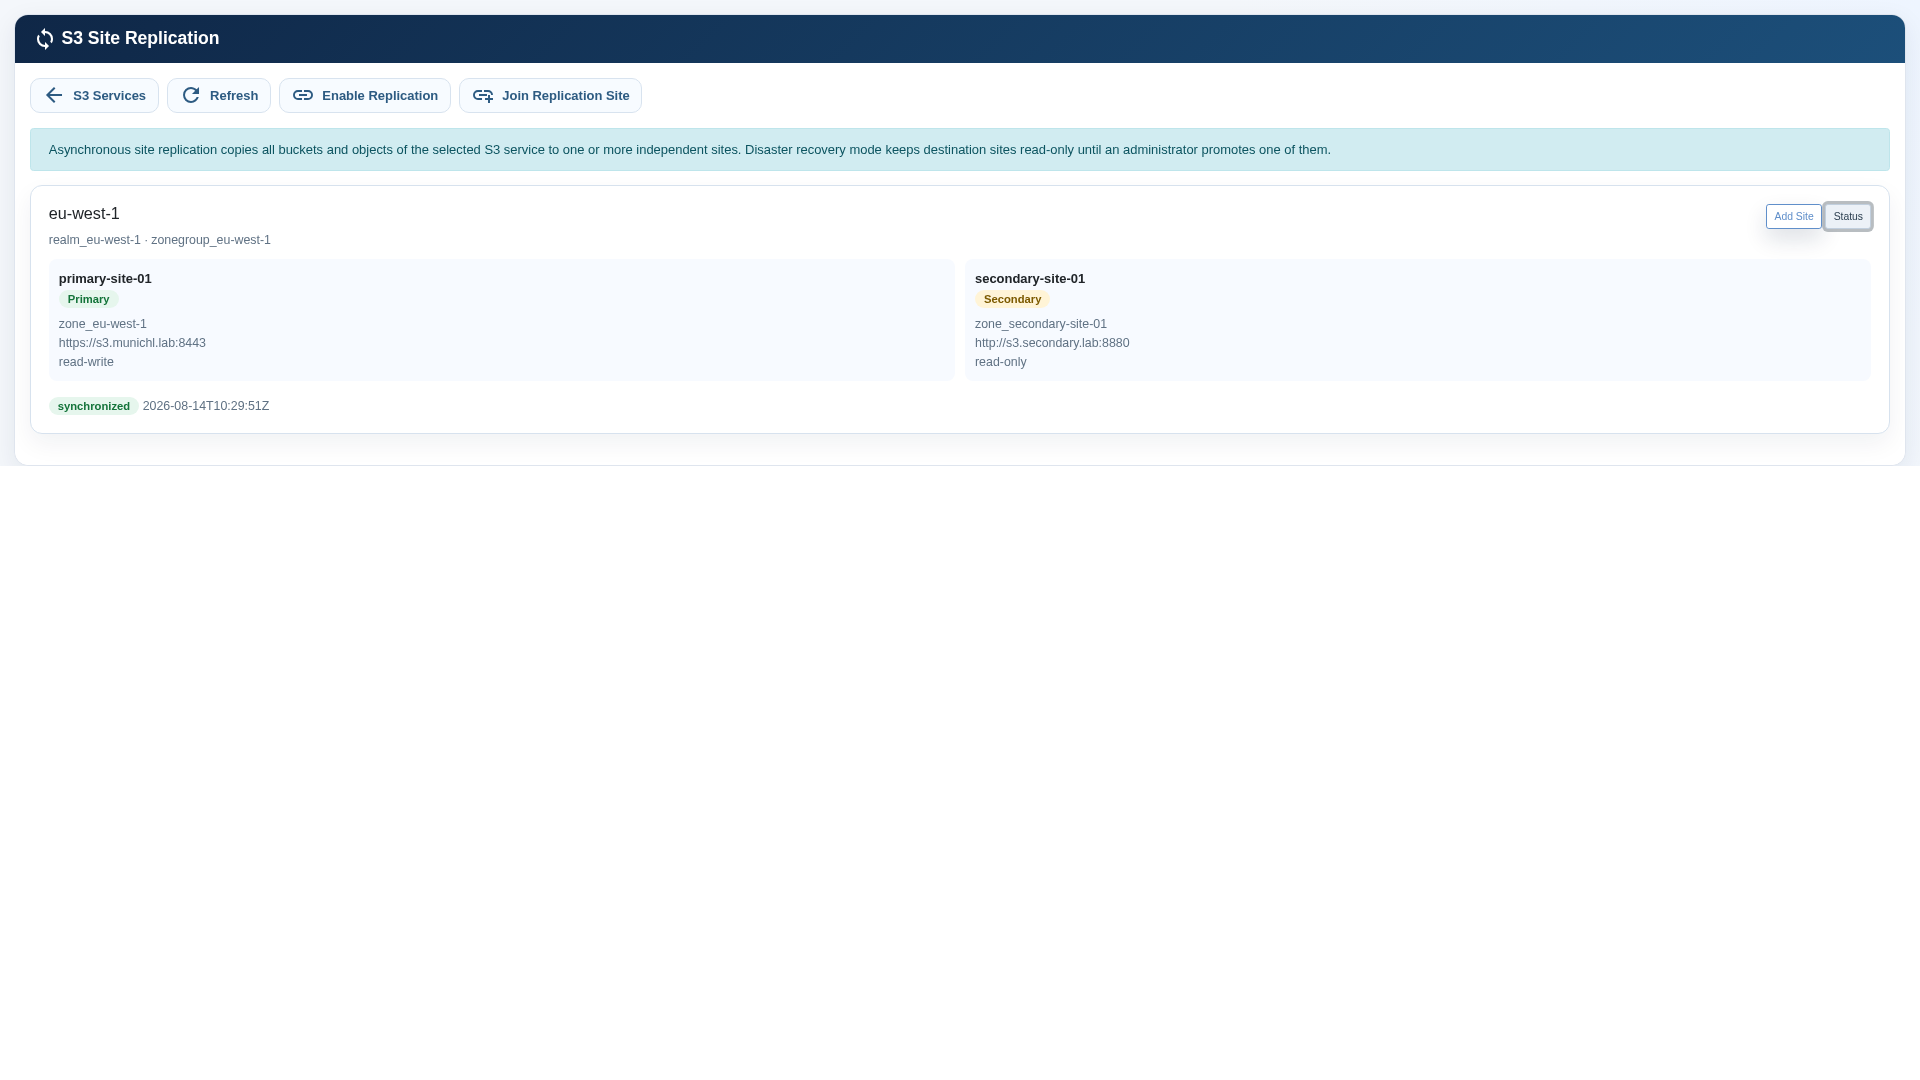
Öffnen Sie die Übersicht und wählen Sie Status. Prüfen Sie beide Standorte, die Rollen Primary und Secondary, den schreibgeschützten Zielzustand und den Status synchronized.
- Prüfen Sie fehlerfreien Clusterzustand und alle vorgesehenen Gateways.
- Laden Sie am Primärstandort ein kleines, unkritisches Testobjekt hoch.
- Lesen Sie es über den Zielendpunkt.
- Bestätigen Sie im DR-Modus, dass ein Schreiben am Ziel abgewiesen wird.
- Löschen Sie das Testobjekt am Primärstandort und bestätigen Sie die übertragene Löschung.
Regelmäßige Überwachung
| Prüfung | Erwarteter Zustand | Maßnahme bei Abweichung |
|---|---|---|
| Beziehung | synchronized | WAN, DNS, Zertifikate und Clusterzustand prüfen. |
| Primärstandort | read-write | Unerwartete Rollenänderung vor Schreibfreigabe untersuchen. |
| DR-Ziel | read-only | Anwendungsschreiben stoppen und Modus prüfen. |
| Gateways | Alle geplanten Instanzen aktiv | Dienst- und Knotenzustand prüfen. |
| Kapazität | Ausreichend frei | Speicher vor Erreichen der Grenzwerte erweitern. |
| Zertifikat | Ausreichend lange gültig | Vor Ablauf an allen Endpunkten erneuern. |
Lokaler Gateway-Failover
Die IP-Gruppe schützt den S3-Endpunkt innerhalb des Standorts. Fällt Gateway oder lokaler Dienst aus, verschiebt der Cluster die Adresse zum nächsten geeigneten Knoten. Clients verbinden sich über denselben DNS-Namen erneut. Client-Timeout und Wiederholungsrichtlinie beeinflussen die sichtbare Unterbrechung.
- Verwenden Sie keine separaten Zugangsdaten je lokalem Gateway.
- Überwachen Sie nach Wartung oder Failover den bedienenden Knoten und die Gateway-Gesundheit.
- Testen Sie lokalen Failover getrennt vom Standort-Disaster-Recovery.
Verfahren bei Standortausfall
Eine Heraufstufung ist eine kontrollierte Disaster-Recovery-Entscheidung und keine automatische Reaktion auf eine vorübergehende Nichterreichbarkeit.
- Bestätigen Sie, dass der Primärstandort keine Schreibzugriffe mehr bedienen kann, und schließen Sie eine Netzwerkpartition aus.
- Dokumentieren Sie letzten Replikationsstatus und geschäftliche Freigabe.
- Prüfen Sie Zielcluster, Speicher, Gateways, Endpunkt und Kapazität.
- Verwenden Sie die freigegebene Heraufstufungsfunktion für den lokalen Sekundärstandort. Fehlt diese in der GUI, halten Sie an und aktualisieren Sie auf eine Version mit freigegebenem Ablauf oder kontaktieren Sie den euroNAS-Support.
- Leiten Sie Clients erst nach bestätigter Schreibfähigkeit um.
- Planen Sie Resynchronisierung und Rollentausch vor der Rückkehr. Erlauben Sie im DR-Modus niemals unkontrollierte Schreibzugriffe an beiden Standorten.
Häufige Probleme
| Anzeige | Wahrscheinliche Ursache | Sichere Reaktion |
|---|---|---|
| Kein Zieldienst | Kein leerer S3-Dienst oder vorhandene Buckets. | Neuen leeren Zieldienst erstellen und Seite aktualisieren. |
| Einladung nicht einlösbar | Token abgelaufen/verwendet, Port blockiert, Adresse oder Zertifikat falsch. | Neue Einladung erstellen und Erreichbarkeit sowie Zertifikat prüfen. |
| behind oder syncing | WAN-Unterbrechung, Rückstand oder zu wenig Durchsatz. | Verbindung und Kapazität wiederherstellen und Aufholen abwarten. |
| error | Endpunkt-, DNS-, Zertifikats-, Gateway- oder Clusterproblem. | Beide Dashboards und Endpunkte prüfen. |
| Ziel im DR-Modus beschreibbar | Unerwartete Rollen- oder Modusänderung. | Schreiben stoppen und Topologie sofort prüfen. |
| S3-Adresse nach Knotenausfall nicht erreichbar | IP-Gruppen- oder Gateway-Problem. | Bedienenden Knoten und Clusterressourcen prüfen. |
Richtlinien, Zugangsdaten und geplante Wiederherstellung
Funktionen, die nur am Primärstandort zulässig sind, werden am Sekundärstandort ausgeblendet. Bucket-Auswahl, geplante Pause und Rotation erfolgen in der primären Beziehungsansicht.
- Wählen Sie alle Buckets oder eine explizite Auswahl und prüfen Sie die Richtlinie nach Bucket-Änderungen.
- Schließen Sie alle vier Rotationsstufen ab und warten Sie vor dem Entfernen des alten Schlüssels auf synchronized.
- Verwenden Sie Test Disaster Recovery für eine Bereitschaftsprüfung ohne Schreibfreigabe.
- Schließen Sie bei einem Ausfall eine Netzwerkpartition aus, stoppen Sie Schreiben am alten Primärstandort, prüfen Sie den Verzug und verwenden Sie Controlled Promotion.
- Verwenden Sie nach Rückkehr Refresh Topology; Erfolg wird erst nach stabilen Gateways und erreichbarem Endpunkt gemeldet.
Validiertes Release-Verhalten
Das Release wurde zwischen zwei unabhängigen Drei-Knoten-Clustern mit 1.000 kleinen Objekten, einem 32-MB-Multipart-Objekt, Versionierung und replizierter Löschung geprüft. Ein neues Testobjekt war nach etwa 12 Sekunden am Sekundärstandort lesbar. Dies ist keine Leistungsgarantie.
- Alle drei Gateways jedes Standorts blieben aktiv.
- Schreiben am schreibgeschützten Ziel wurde abgewiesen.
- Failover und Failback bewahrten die Single-Writer-Rolle.
- Unsichere Heraufstufung, destruktives Entfernen und Active-Active ohne Bestätigung wurden abgewiesen.
- GUI- und REST-API-Abläufe wurden nach der Wiederherstellung validiert.
Änderungsmanagement
- Vor Wartung Konfiguration sichern und synchronized bestätigen.
- Nur eine Infrastrukturänderung gleichzeitig durchführen und beide Standorte prüfen.
- DNS-Namen nicht ohne vollständige Topologieprüfung ändern.
- Nach Änderungen an IP-Gruppe oder Gateway-Knoten Namensauflösung auf allen Knoten prüfen.
- Zertifikate rechtzeitig erneuern und mit einem unkritischen Client testen.
- Unabhängige Backups beibehalten und Wiederherstellung separat testen.
Abnahmecheckliste
- Beide Cluster sind fehlerfrei.
- Standortnamen und Rollen sind korrekt.
- Ziel ist schreibgeschützt, sofern nicht anders freigegeben.
- Beziehung ist synchronized.
- Erstellung, Ziellesen und replizierte Löschung funktionieren.
- Zielschreiben wird im DR-Modus abgewiesen.
- Lokaler Gateway-Failover ist an beiden Standorten getestet.
- Monitoring, Alarme, Kapazitäts- und Zertifikatsprüfungen sind aktiv.
- Freigabe, Client-Umleitung und Rückkehr sind dokumentiert.
- Unabhängige Backups und Wiederherstellung sind getestet.
Erweiterte Richtlinien, Überwachung und Wiederherstellung
Das Fenster Replikationsrichtlinie ist in Registerkarten gegliedert, damit die erweiterten Einstellungen auch bei geringer Bildschirmhöhe übersichtlich bleiben. Alle Schritte erfolgen über die grafische Oberfläche.
- Erweiterte Regeln: Einweg- oder Zweiweg-Regeln erstellen, Quell- und Zielstandorte sowie Buckets auswählen und optional nach Objektschlüssel-Präfix oder Objekt-Tags filtern. Zielbesitzer und Speicherklasse können zugeordnet werden.
- Schutz: Löschungen spiegeln, versionierte Objekte behalten, Löschungen in einem geplanten externen Archiv verzögern oder den geschützten reinen Kopiermodus verwenden. Erforderliche Versionierung und Object Lock werden vor dem Speichern geprüft.
- Überwachung und Warnungen: E-Mail, vorhandene Cluster-Benachrichtigungen, Webhooks und Prometheus-Metriken konfigurieren. Vorgänge zeigt Bucket-Bestand, Fehler, RPO-Verlauf und Kapazitätsprognose.
- Vorhandene Objekte nachreplizieren: Nach einer neuen oder geänderten Regel den Hintergrundabgleich starten. Nachreplikationsaufträge zeigt Fortschritt und ermöglicht Pausieren, Fortsetzen oder Abbrechen.
- Wiederherstellung: Bereitschaft vor der Heraufstufung prüfen. Geschützte Hooks, Prüf-URL und DNS-/Load-Balancer-Integration lassen sich zu einem protokollierten Ablauf mit Rollback kombinieren.
- Externes Archiv: neutralen Namen, S3-kompatible Adresse, Bucket, Zugangsdaten, Kopier-/Synchronmodus und Zeitplan festlegen. Zugangsdaten bleiben geschützt und werden später nicht angezeigt.
- Compliance-Bericht: PDF- und CSV-Nachweise unter Vorgänge erstellen. Sie enthalten Topologie, Synchronisierungsstatus, Richtlinie, Bucket-Bestand und Ereignisanzahl.