
Hyperkonvergenter Ceph für Virtualisierung
Virtuelle Maschinen und verteilter Ceph-Speicher werden auf denselben eEVOS-Hosts ausgeführt. Die Architektur macht ein separates Speichersystem überflüssig, verteilt Daten über Host-Ausfalldomänen hinweg und vereint Rechenleistung, Speicher, Hochverfügbarkeit und VM-Schutz auf einer einzigen Betriebsplattform
Rechenleistung jederzeit hinzufügen: Reine Rechenknoten nutzen automatisch den vorhandenen Ceph-Speicher
Compute und Speicher teilen sich den Cluster
Jeder teilnehmende eEVOS-Host kann virtuelle Maschinen ausführen und lokale Speichergeräte zum Ceph-Cluster beitragen. Ceph verteilt VM-Daten gemäß der gewählten Schutzrichtlinie und dem Ausfallbereichsdesign auf mehrere Hosts
Dies ist ein Scale-Out-Modell: Das Hinzufügen eines Speicher beitragenden Knotens erhöht die Rechenressourcen, die Speicherkapazität und die aggregierte E/A-Leistung. Falls zusätzliche Rechenleistung benötigt wird, können jederzeit reine Rechenknoten (eEVOS) ohne lokale Speichergeräte (Ceph) hinzugefügt werden. Diese nutzen automatisch den vorhandenen Speicher (Ceph) für ihre virtuellen Maschinen
Ein Cluster, zwei Ressourcenebenen
Virtuelle Maschinen nutzen Rechenressourcen auf eEVOS-Hosts, während sich ihre virtuellen Festplatten auf der verteilten Ceph-Speicherebene befinden. Ceph-Clients kommunizieren direkt mit Speicherdiensten; die Datenplatzierung wird anhand der Clusterkarte berechnet und nicht über einen zentralen Speichercontroller geleitet
Ceph-Dienste
Lokale NVMe/SSD
Ceph-Dienste
Lokale NVMe/SSD
Ceph-Dienste
Lokales NVMe/SSD
Verteilter Ceph Speicher
VM-Blöcke werden gemäß Poolrichtlinie und CRUSH-Fehlerdomänenregeln auf OSDs verteilt
Monitore verwalten Cluster-Maps und Quorum. OSDs speichern Daten, replizieren sie und beteiligen sich an Wiederherstellung und Rebalancing
Konzeptdiagramm. Die genaue Serviceplatzierung, Replikationsrichtlinie, Netzwerktrennung und Knotenanzahl werden während der Dimensionierung festgelegt
Drei Entscheidungen prägen das Ergebnis
01
Ausfalldomänen und Datenrichtlinie
Definieren Sie, welche Ausfälle der Cluster tolerieren muss. Ein typisches Produktionsdesign verwendet mindestens drei unabhängige Host-Ausfalldomänen mit drei Replikaten; die endgültige Basislinie hängt von Quorum-, Pool- und Verfügbarkeitsanforderungen ab
02
Ressourcentrennung
CPU, Speicher, PCIe-Bandbreite und Speichermedien werden von VM- und Ceph-Workloads gemeinsam genutzt. Reservieren Sie Ressourcen für Speicherdienste, Wiederherstellung und Wartung, anstatt die Dimensionierung nur für den stationären VM-Bedarf vorzunehmen
03
Netzwerkarchitektur
Entwurf redundanter Pfade und ausreichender Bandbreite für VM-Datenverkehr, Speicher-E/A, Replikation, Wiederherstellung, Live-Migration und Verwaltung. Netzwerklatenz und -überlastung beeinträchtigen den gesamten Cluster
Warum Unternehmen sich für HCI entscheiden – und welche Einschränkungen sie akzeptieren:
Stärken:
- Kein separates Shared-Storage-Array erforderlich
- Compute und der Speicher können schrittweise auf Standard-Serverhardware erweitert werden
- Daten werden auf definierte Ausfalldomänen verteilt, anstatt an ein einzelnes Controller-Paar gebunden zu sein
- VM-Migration, Hochverfügbarkeit, virtuelles Netzwerk und Speicher werden von der eEVOS-Umgebung aus betrieben
- Reine Rechenknoten können jederzeit ohne zusätzlichen Speicher hinzugefügt werden; sie nutzen automatisch den vorhandenen Ceph-Speicher
- VM-Backup (eEVOS), Disaster Recovery (Instant Backup & Recovery) und Offsite-DR können die Virtualisierungsschicht schützen
Was geplant werden muss:
- Speicherworkloads konkurrieren um Host- und Netzwerkressourcen
- Das Ausfallen eines Hosts reduziert gleichzeitig die VM- und Speicherkapazität
- Wiederherstellung und Rebalancing erzeugen erheblichen zusätzlichen E/A- und Netzwerkverkehr
- Ausreichende Kapazitätsreserve ist erforderlich; ein nahezu voll ausgelasteter verteilter Cluster stellt ein Betriebsrisiko dar
- Hardware-Asymmetrie, langsame Übertragungsmedien oder ein schwacher Netzwerkpfad können die Cluster-weite Latenz beeinträchtigen
- Das Betriebsmodell ist komplexer als ein einzelner Server oder ein synchrones Spiegeln zweier Knoten
Das Netzwerk ist Teil des Speichersystems
Ceph-Clients kommunizieren direkt mit OSDs, und OSDs tauschen Daten für Replikation, Wiederherstellung und Rebalancing aus. Ein robustes Design behandelt daher Switching, Verkabelung, Netzwerkkarten und Pfadredundanz als Speicherkomponenten
Vorderseite
VM- und Client-Datenverkehr
Nord-Süd-Anwendungsverkehr, Administration und Zugriff auf virtuelle Dienste. Segmentierung mit VLANs und Richtlinien gemäß Sicherheitskonzept
Storage
Öffentlicher Datenverkehr von Ceph
VM-Speicher-I/O und Client-zu-OSD-Kommunikation von Ceph. Dimensionierung für Workload-Latenz und -Durchsatz, nicht nur für Verbindungsgeschwindigkeit
Rückseite
Replikation und Wiederherstellung
Ein separates Clusternetzwerk von Ceph kann Heartbeat-, Replikations- und Wiederherstellungsdatenverkehr isolieren, wenn das Workload- und Resilienzmodell die zusätzliche Komplexität rechtfertigt
Planen Sie den Normal- und den eingeschränkten Betrieb
Hyperkonvergenz ist eine Option, nicht die Standardlösung
| Entscheidung | eEVOS mit Ceph HCI | eEVOS mit gemeinsam genutztem Speicher | Dedizierter Speicher für eEKAS und Ceph |
|---|---|---|---|
| Primäre Rolle | Virtualisierung Speicher für Compute und Ceph im selben Cluster | Virtualisierung eEVOS-Berechnung mit einem separaten gemeinsam genutzten Speichersystem | Storage-Dienst Dedizierter, skalierbarer Block-, Datei- und Objektspeicher für unabhängige Nutzer |
| Skalierungsmodell | Rechenleistung und Speicher gemeinsam hinzufügen oder jederzeit reine Rechenknoten hinzufügen; reine Rechenknoten nutzen automatisch den vorhandenen Ceph-Speicher | Rechenleistung und Speicher unabhängig skalieren | Speicherkapazität und Dienste unabhängig von der Virtualisierungsplattform skalieren |
| Optimale Lösung | Organisationen, die einen integrierten Virtualisierungsstack ohne externes Array suchen | Standorte mit einer bestehenden SAN/NAS-Strategie oder strikter Trennung von Rechenleistung und Speicher | Gemeinsam genutzter Unternehmensspeicher, S3/Objekt-Anwendungsfälle und mehrere Client-Plattformen |
| Betriebsgrenze | Eine eEVOS-Umgebung für VM-Lebenszyklus, Hochverfügbarkeit, Speicher und VM-Schutz | eEVOS plus das Betriebsmodell des externen Arrays | Dedizierte Speicheroperationen und Service-Endpunkte; Virtualisierung bleibt separat |
Ein vergleichbares HCI-Prinzip, keine Funktionsäquivalenz
Architektonische Ähnlichkeiten
Beide Ansätze aggregieren lokale Geräte über mehrere Virtualisierungshosts hinweg und stellen verteilten Speicher für virtuelle Workloads bereit. Compute, Speichergeräte und das Speichernetzwerk bestimmen gemeinsam das Plattformverhalten
Dies macht eEVOS mit Ceph zu einer relevanten Architekturalternative, wenn ein Unternehmen ein vSAN-basiertes Bereitstellungsmodell prüft
Was nicht abgeleitet werden sollte
eEVOS mit Ceph ist nicht VMware vSAN, und die Produkte sind nicht funktionsidentisch Die Richtliniensemantik, Lebenszyklus-Workflows, Kompatibilitätsregeln, Managementintegrationen und Betriebstools von Storage unterscheiden sich
Bei einer Migrationsentscheidung sollten neben den Lizenzkosten auch das erforderliche Workload-Verhalten, die Wiederherstellungsziele, die Hardwareunterstützung, der Betrieb im laufenden Betrieb und die Backup-Strategie berücksichtigt werden
eEVOS im Einsatz
Die Screenshots zeigen die Betriebsschicht der Architektur. Wählen Sie ein Bild aus, um es in voller Größe anzuzeigen, ohne die Seite zu verlassen
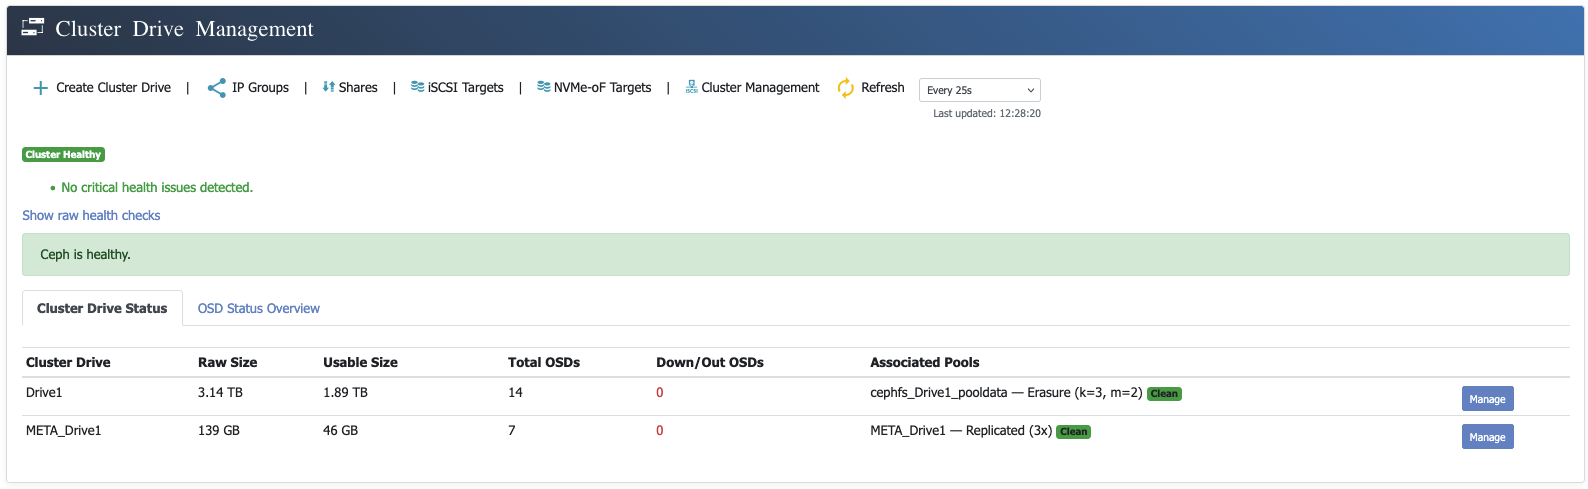 Ceph Cluster-LaufwerksverwaltungClusterzustand, Roh- und Nutzkapazität, OSD-Status und zugehörige Ceph-Pools an einem Ort anzeigen
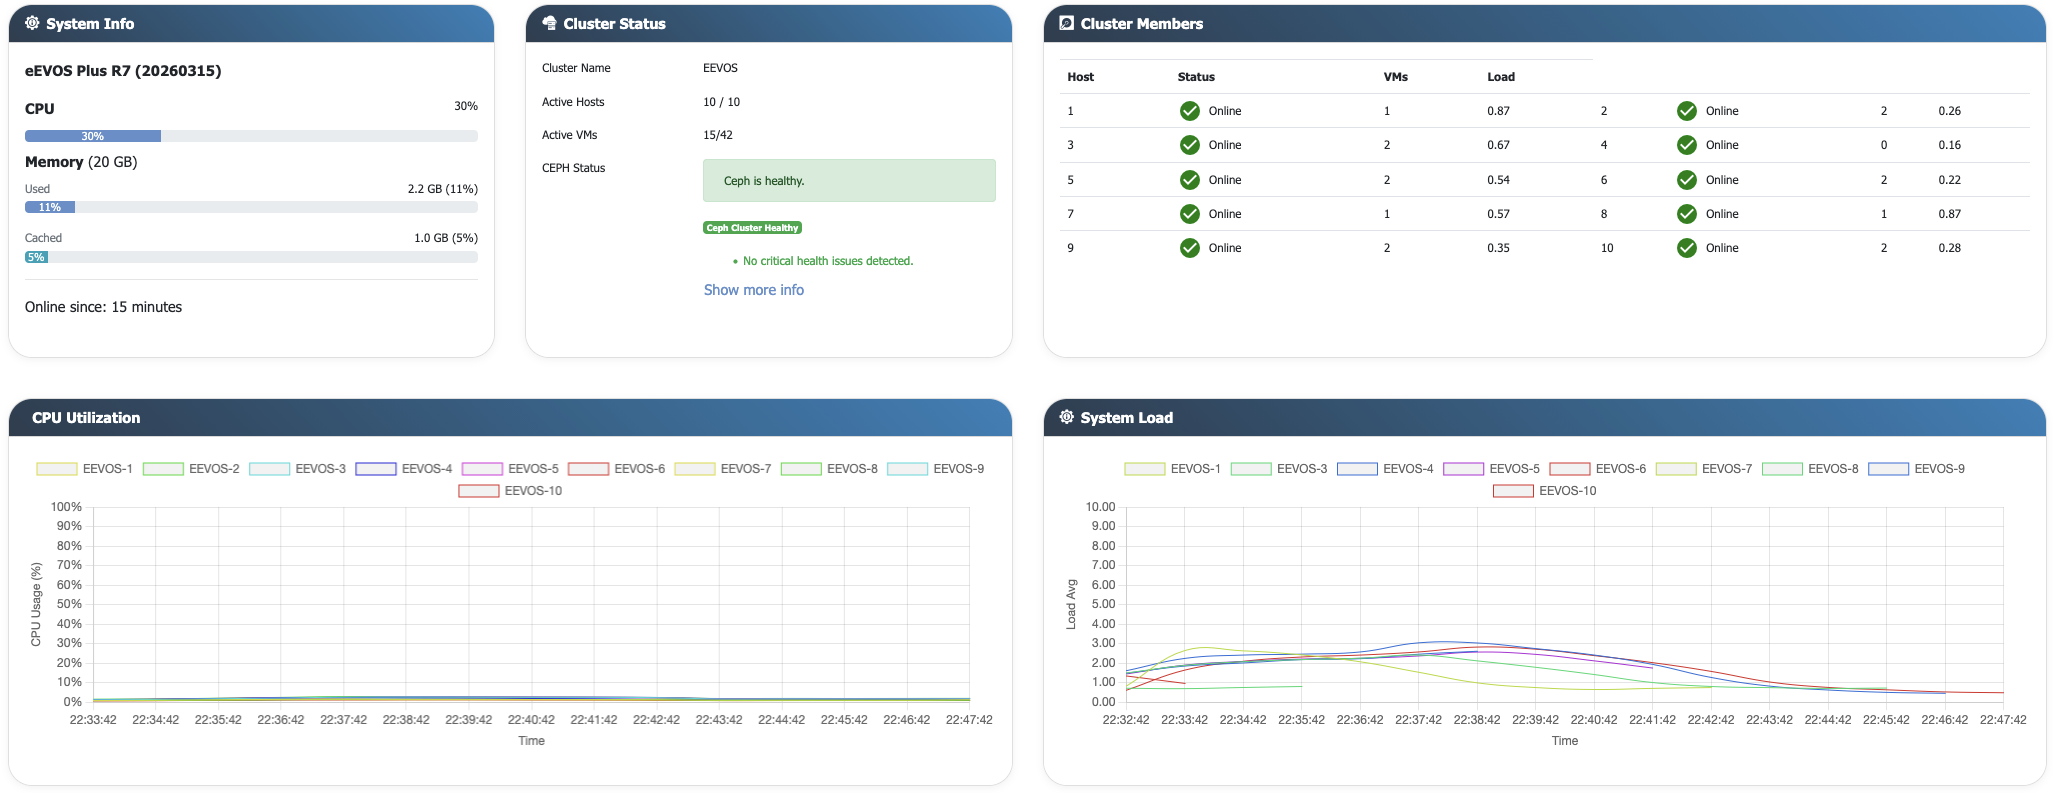 Multi-Node-DashboardClusterweite Transparenz für Hosts, virtuelle Maschinen und Ressourcenstatus
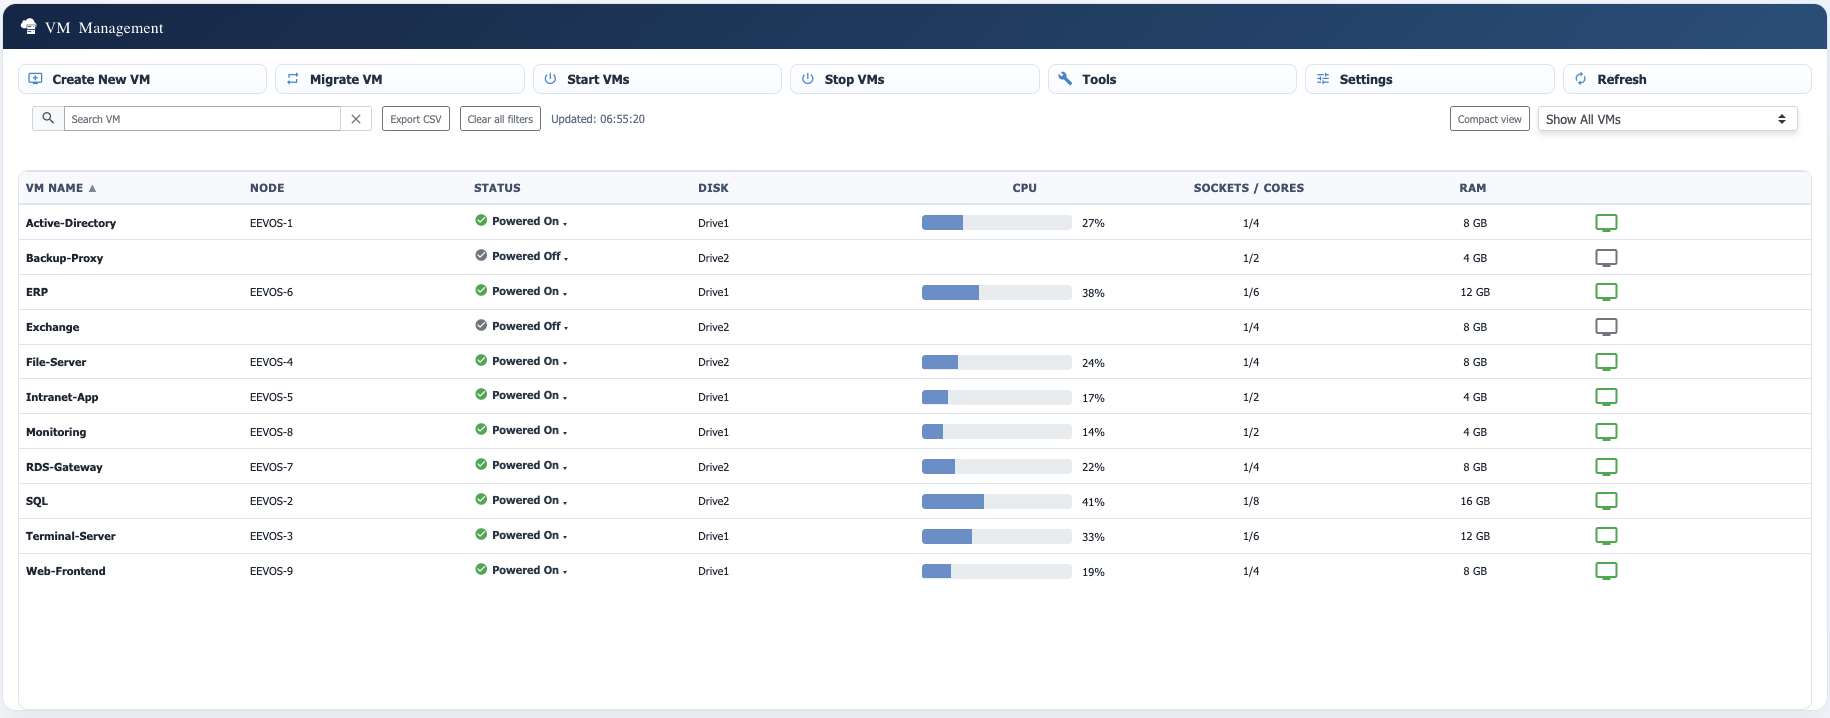 Verwaltung virtueller MaschinenVM-Lebenszyklus und -Platzierung über die Verwaltungsschnittstelle eEVOS
Die Architektur sollte evidenzbasiert sein
Ceph dokumentiert die direkte Client-OSD-Kommunikation, die CRUSH-basierte Datenplatzierung, replizierte Pools und konfigurierbare Fehlerdomänen. Die Netzwerkdokumentation erläutert zudem die durch Replikation und Wiederherstellung entstehende zusätzliche Last. VMware beschreibt vSAN als verteilten Speicher, der lokale Geräte über Cluster-Hosts hinweg aggregiert; dies unterstützt den obigen Architekturvergleich, wobei produktspezifisches Verhalten jedoch gesondert betrachtet wird
Ceph-Architektur • Ceph-Netzwerkkonfigurationsreferenz • Broadcom: vSAN-Leistung und -Architektur verstehen
Die richtige Architektur für Ihre Workloads besprechen
Wir können Knotenrollen, Ausfalldomänen, Netzwerkdesign, nutzbare Kapazität, Wiederherstellungsverhalten und die Eignung eines hyperkonvergenten Ceph-Clusters, eines gemeinsam genutzten Speichers oder eines dedizierten eEKAS-Clusters überprüfen