
Objektspeicher für Anwendungen, Archive und geschützte Daten
S3 speichert Daten als Objekte in Buckets und stellt sie über eine API bereit. Er eignet sich hervorragend für moderne Anwendungen, Backup-Repositories und große unstrukturierte Datensätze und kann über AWS CLI oder ein integriertes S3 File Manager verwaltet werden
Was unterscheidet ein Objekt?
Ein S3-Objekt kombiniert die Daten selbst, beschreibende Metadaten und einen eindeutigen Schlüssel. Anwendungen greifen über HTTP-basierte API-Operationen auf Objekte zu, anstatt eine herkömmliche Festplatte einzubinden oder ein POSIX-Dateisystem zu durchsuchen
Buckets bilden die oberste administrative Grenze für Zugriff, Kontingente, Versionierung, Lebenszyklus und AufbewahrungseinstellungenEin Objekt besteht aus drei wesentlichen Teilen:
Block, Datei und Objekt ergänzen sich
Die richtige Wahl hängt davon ab, wie die Anwendung auf Daten zugreifen und diese organisieren möchte| Modell | Anwendung sieht | Am besten geeignet für | Wichtige Überlegung |
|---|---|---|---|
| Block | Rohdatenvolumen | Virtuelle Maschinen, Datenbanken und Host-Dateisysteme | Der Host besitzt das Dateisystem und die Struktur |
| Datei | Dateien und Verzeichnisse | Benutzerfreigaben, kollaborative Workflows und Anwendungen, die SMB/NFS erwarten | Verzeichnis- und Sperrsemantik sind Teil des Dienstes |
| Objekt / S3 | Buckets, Objekte und Metadaten über eine API | Anwendungen, Backup, Archiv und große unstrukturierte Datensätze | Anwendungen müssen die S3-Semantik oder eine geeignete Integration verwenden |
Nutzen Sie S3, wenn sein Betriebsmodell einen Mehrwert bietet
Optimale Eignung
- Backup- und Langzeitarchivierungsspeicher
- Anwendungsdaten, auf die über eine S3-API zugegriffen wird
- Archive und große unstrukturierte Datensätze
- Mediendateien, Forschungsdaten und Datenpipelines
- Workloads, die von Objektmetadaten und Lebenszyklusregeln profitieren
Betrachten wir ein anderes Zugriffsmodell:
- Anwendungen, die ein rohes Blockgerät benötigen
- VM-Datenspeicher, die Block- oder unterstützte Shared-File-Protokolle erwarten
- Workflows, die von traditionellen Dateisperrungen und POSIX-Semantik abhängig sind
- Häufige In-Place-Änderungen kleiner Bereiche innerhalb großer Dateien
- Legacy-Software ohne S3-Unterstützung oder ein qualifiziertes Gateway
Getrennter Clientzugriff vom verteilten Datenschutz
Der S3-Endpunkt akzeptiert API-Anfragen und leitet Operationen an die Objektschicht weiter. Anwendungen können sich direkt über die S3-API verbinden, während Benutzer ein separates S3 File Manager mit eigener Authentifizierung und Benutzeroberfläche verwenden können
Dies ist der normale API-Pfad für automatisierte Systeme und bestehende S3-Integrationen
Wie bei Diensten wie AWS oder Wasabi können Benutzer Buckets erstellen und verwalten, Dateien hoch- und herunterladen, Objekte organisieren und Freigabefunktionen entsprechend ihren Berechtigungen nutzen
AWS CLI mit dem privaten Endpunkt S3 verwenden
AWS CLI auf die Service-URL verweisen und die von der Plattform ausgegebenen Zugriffs- und geheimen Schlüssel verwenden. Bekannte Befehle wie ls, cp und sync Private S3-Speicher können dann adressiert werden, ohne den Datenpfad über AWS zu leitenaws --endpoint-url https://s3.example.com s3 ls
Versionierung, Object Lock und Backup sind nicht dasselbe
Jede Kontrollmaßnahme deckt ein anderes Risiko ab. Ein robustes Design kombiniert in der Regel mehrere EbenenGrafische Steuerung von Buckets, Benutzern und Aufbewahrung
Die routinemäßige Administration ist unabhängig von den Befehlszeilentools von S3. Eine grafische Servicekonsole kann Benutzer und Buckets erstellen, Zugriffsschlüssel ausgeben, Quoten anwenden und WORM, Richtlinien, CORS, Lebenszyklusregeln und Zugriffsprotokollierung konfigurieren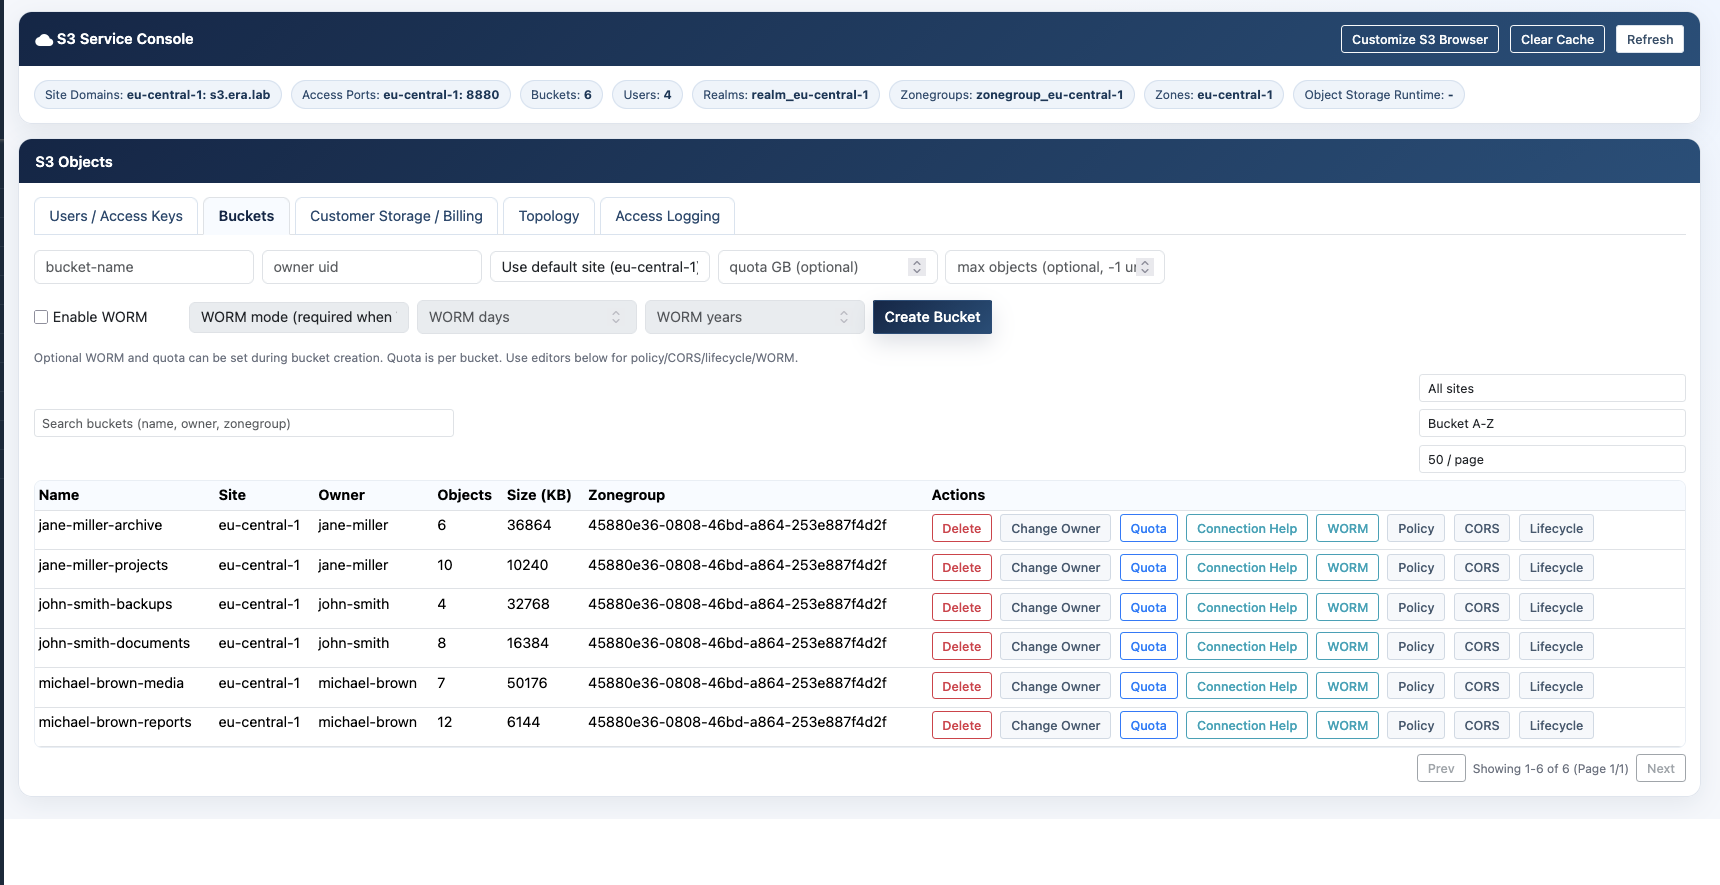 Bucket-Verwaltung in der eEKAS-ServicekonsoleDie Schnittstelle vereint gängige S3-Governance-Aufgaben in einer einzigen Betriebsansicht
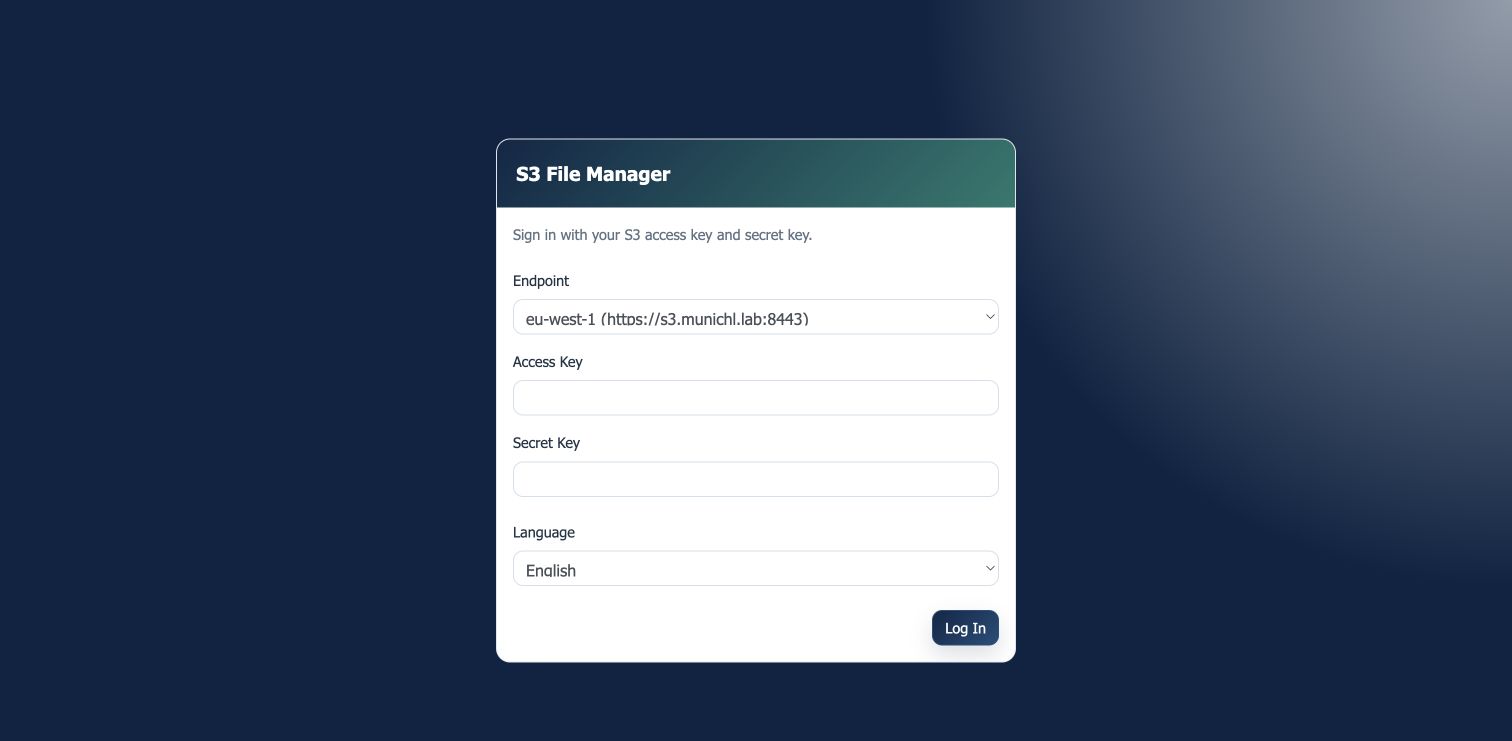 Integrierte Endbenutzer-S3 File ManagerBrowserbasierter Zugriff auf Buckets und Objekte ohne separaten S3-Client
S3-Zugriff für Benutzer – nicht nur für Anwendungen
Viele Objektspeicherprodukte stellen zwar eine S3-API und eine Administratorkonsole bereit, lassen Endbenutzer jedoch von Drittanbietersoftware abhängig. eEKAS beinhaltet eine browserbasierte S3 File Manager-Oberfläche, sodass autorisierte Benutzer über eine vertraute Schnittstelle mit ihren eigenen Buckets arbeiten können Für den täglichen Objektzugriff sind weder Kommandozeilenkenntnisse noch ein lokal installierter S3-Client erforderlich- Buckets und Ordner erstellen
- Objekte hochladen, herunterladen, umbenennen, kopieren, verschieben und löschen
- Ordner als ZIP-Archive herunterladen
- Vorab signierte Links und kontrollierte öffentliche URLs erstellen
- Objektdetails und verfügbare Versionen überprüfen
- Bucket-Versionierung, WORM, Lebenszyklus- und Kontingentoptionen verwalten
Wo Enterprise S3 praktischen Nutzen bietet
Premium, HA Cluster und eEKAS erfüllen unterschiedliche Anforderungen
Alle drei Plattformen bieten Zugriff und eine S3-Plattform, verwenden jedoch unterschiedliche Speicherarchitekturen und bieten unterschiedliche Kontingent- und Abrechnungsfunktionen| Plattform | Architektur | Kontingentoptionen | S3 File Manager | Abrechnungsfunktionen | Empfohlene Verwendung |
|---|---|---|---|---|---|
| euroNAS Premium | Einzelserver-Betriebssystem Storage | Bucket-Kontingent | Enthalten | Nicht enthalten | Standalone- oder interne Dienste S3 mit einfachen Anforderungen |
| euroNAS HA Cluster | Hochverfügbares Speicherpaar | Bucket-Anzahl-Kontingent | Eingeschlossen | Nicht eingeschlossen | Interne S3-Dienste, die eine hohe Speicherverfügbarkeit erfordern |
| eEKAS | Ceph-basierter verteilter Scale-Out-Cluster | Storage-Kapazitäts- und Bucket-Anzahl-Kontingente | Eingeschlossen | Nutzungserfassung und Abrechnungsexport | Scale-out Enterprise S3 und kundenorientierte MSP- oder Cloud-Provider-Dienste |
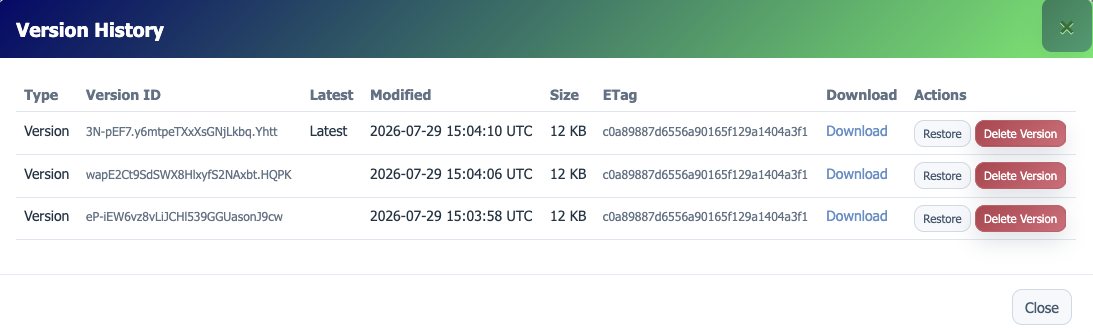 ObjektversionsverlaufFrühere Objektversionen überprüfen, herunterladen oder wiederherstellen
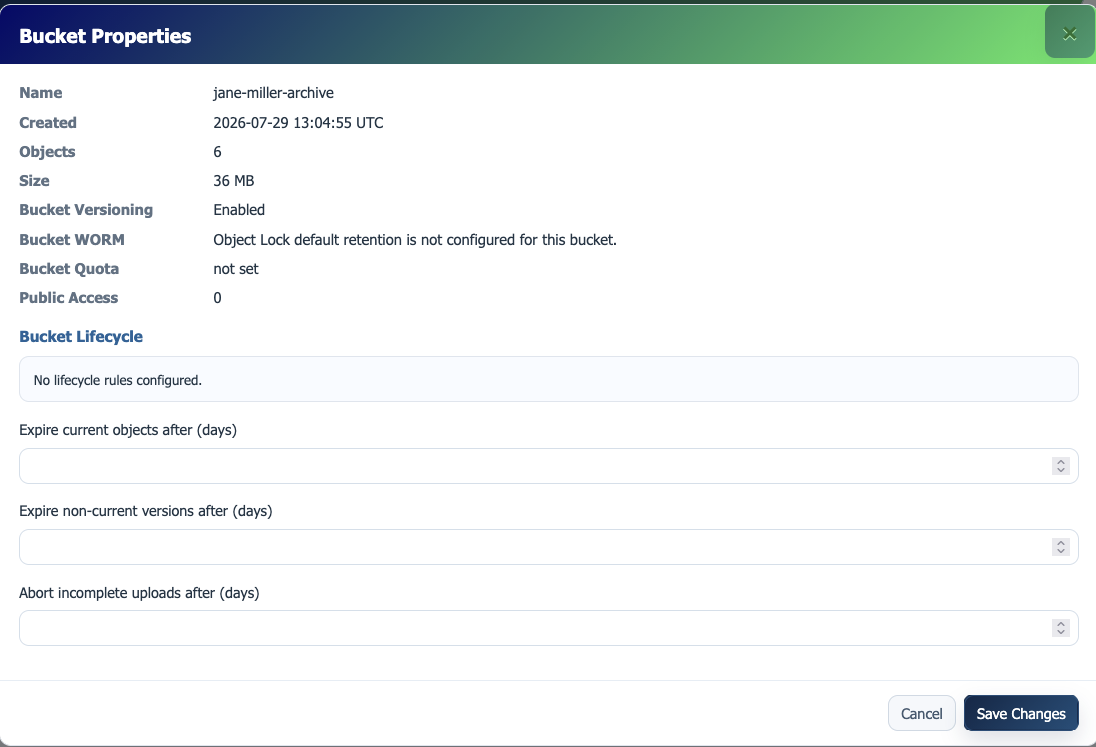 Bucket-EigenschaftenVersionierung, WORM, Kontingent, öffentlicher Zugriff und Lebenszyklusstatus überprüfen